KI produziert immer mehr wissenschaftliche Paper. Die Frage, wer die alle lesen und prüfen soll, könnte ein Programm aus Deutschland beantworten.
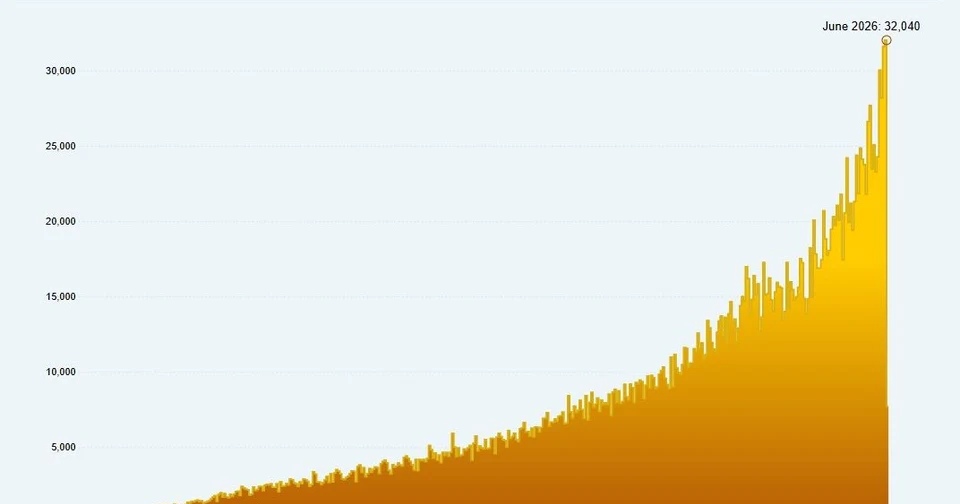
Die Ausgangslage ist klar: Die Zahl wissenschaftlicher Paper explodiert durch KI. Zeitschriften und Konferenzen werden mit Einreichungen geflutet, siehe aktuell die ICLR, die Konferenz für maschinelles Lernen.
Zeitschriften-Macher und Konferenz-Veranstalter haben keinen Überblick mehr: Was muss rein? Was kann raus? Und wie überhaupt die Masse sichten, um eine Entscheidung zu treffen?
Das Problem der Überwältigung durch schiere Masse existiert auch auf der Seite der Leser. Welches der vielen Paper ist es wert, studiert zu werden? Nach welchen Kriterien wählt man aus?
Die meisten nutzen – neben anekdotischer Evidenz und „Kenn-ich“-Kenngrößen – zumindest ab und an Publikations- und Zitationsmetriken. Wo ist ein Paper erschienen? Wie oft wurde es zitiert? Von wem? Wie ist seine Bedeutung im wissenschaftlichen Feld? Und so weiter.
KI als Lösung: zwei Ansätze
KI kann mehr. Zwei Ansätze gibt's schon:
1.) Das Unternehmen QED Science hat 57.455 bioRxiv-Preprints auf Originalität und Validität untersucht und das oberste 1 % ausgewählt. Erste Preprint-Server wollen das Scoring nutzen. Ob KI tatsächlich die „besten“ Paper erkennen kann, ist allerdings eine komplexe Frage. Wichtig ist vor allem, die Auswahl so offen wie möglich zu machen.
2.) Das führt mich zu Ansatz Nr. 2, den ich besonders interessant finde, auch weil er aus Deutschland kommt. Auf LinkedIn hat aber kaum jemand bisher darüber gesprochen. Ein Team vom Forschungszentrum Jülich hat im Juni die Metascience Novelty Indicators Challenge gewonnen. Ihr Ansatz misst mit Hilfe von KI, was zum Zeitpunkt einer Publikation bekannt war, und bestimmt dann, was die Arbeit an Neuem beiträgt, z. B. eine neue Methode, ein überraschendes Ergebnis oder die Lösung eines offenen Problems. Daraus errechnet sich ein Neuigkeits-Score, versehen mit einem Unsicherheitsintervall und einer Begründung des Ergebnisses.
Vom Forschungsprojekt zur praktischen Anwendung
Klingt nach „spannendes Forschungsprojekt“, ist aber schon praktisch relevant, denn die Datenbank OpenAlex prüft gerade, ob sie den Novelty Score als Indikator aufnimmt. Eine Umfrage soll herausfinden, wer einen solchen Score nutzen würde. Und wofür. Und unter welchen Bedingungen man ihm vertrauen kann.
OpenAlex zeige ich in meinen Workshops. Die meisten kennen es leider nicht. Dabei enthält es hunderte Millionen Paper und hat sogar eine semantische Suche.
KI verändert nicht nur die Recherche und ihre Infrastruktur, sondern auch, wie wir Ergebnisse bewerten.
Aber das nur am Rande. Wichtig ist zu verstehen: KI verändert nicht nur die Recherche und ihre Infrastruktur, sondern auch, wie wir Ergebnisse bewerten. Es entstehen gerade neue Mess-Instrumente – und wir sollten mithelfen, dass sie gut werden und transparent sind.
Ich habe deshalb bei der OpenAlex-Umfrage mitgemacht. Weil wir die Diskussion und die Daten brauchen. Denn: Die Zukunftsmusik spielt bereits zum Tanz! In den Zeitschriften-Redaktionen und Konferenzgruppen – und auch in unseren Recherche-Tools.