Lernen und Material › Recherche mit KI

Recherche mit KI: Vertiefung

Wie KI die wissenschaftliche Recherche verändert, wie aus einer Forschungsfrage ein präziser Prompt wird und was Allzweck-KI, Fachdatenbanken mit KI-Assistent und spezialisierte Recherchetools leisten. Fachübergreifend, mit Beispielen.

Lernseite

Kernbotschaften

  • Breit angelegte Prompts kartieren ein Forschungsfeld, präzise Prompts strukturieren die Evidenzsuche.
  • Konnektoren bei Claude werden nicht automatisch genutzt, auch wenn sie verbunden sind: im Prompt ausdrücklich erwähnen.
  • Die semantische Suche von OpenAlex versteht thematische Beschreibungen, aber keine Arbeitsanweisungen: Metaanweisungen und Ausschlüsse gehören in Filter oder eigene Suchschritte.
  • KI-Zusammenfassungen sind Ausgangsmaterial, kein Beleg: Geprüft wird nach dem Gewicht der Aussage, die 3 bis 5 tragenden Aussagen immer im Original.
  • KI-Suchen sind nicht reproduzierbar, deshalb braucht KI-gestützte Recherche neue Formen der Dokumentation.

Die Kapitel im Überblick

1

Ziele und Ausgangslage: Wie KI die Recherche verändert

  • Vorbemerkungen
  • Was sind die Ziele dieser Veranstaltung?
  • Wie verändert KI die (wissenschaftliche) Recherche?
Zu den Folien dieses Kapitels
2

Halluzinationen und Gegenmittel

  • Wie groß ist das Problem der KI-Halluzinationen?
  • Was kann man gegen KI-Halluzinationen machen?
  • Wie groß ist das Problem der KI-Halluzinationen? Neue Zahlen
Zu den Folien dieses Kapitels
3

Fachbegriffe und Rechercheprompts

  • Warum sind und bleiben präzise Fachbegriffe auch bei KI-gestützten Recherchen wichtig?
  • Warum reicht ein allgemeiner (breiter) Prompt für eine gezielte Recherche nicht aus?
  • Welche Funktionen erfüllt ein breit angelegter Prompt – und welche nicht?
Zu den Folien dieses Kapitels
4

Recherche-Infrastruktur und Allzweck-KI (Claude, ChatGPT)

  • Wie sieht die wissenschaftliche Recherche-Infrastruktur (ungefähr) aus?
  • Warum fehlen ChatGPT, Gemini, Claude und Co in der Recherche-Übersicht?
  • Wie kann ich eine „Allzweck-KI“ wie Claude für die wissenschaftliche Recherche nutzen?
Zu den Folien dieses Kapitels
5

Fachdatenbanken mit KI: Scopus AI und WISO

  • Wie funktioniert ScopusAI
  • Warum ist eine einzelne KI-Recherche kein reproduzierbares Endergebnis?
  • Wie funktioniert ScopusAI?
Zu den Folien dieses Kapitels
6

Google Scholar Labs, OpenAlex und weitere Suchmaschinen

  • Google Scholar Labs
  • Wie funktioniert Google Scholar Labs?
  • Welche Stärken und Schwächen hat Google Scholar Labs?
Zu den Folien dieses Kapitels
7

alphaXiv und Wege zur Literatur

  • Wie funktioniert alphaXiv?
  • Welche Stärken hat alphaXiv?
  • Welche Schwächen hat alphaXiv?
Zu den Folien dieses Kapitels
8

KI-Tools im Überblick

  • Auswahl wissenschaftsspezifischer KI-Tools für die Daten- und Literaturrecherche (Zugang durch Klick auf die jeweiligen Grafiken)
  • Was muss bei der wissenschaftlichen Recherche mit KI-Tools generell beachtet werden?
Zu den Folien dieses Kapitels
9

scienceOS

  • Was ist scienceOS?
  • Wie funktioniert die explorative Recherche und wie selektiert scienceOS Literatur?
  • Wie funktioniert ScienceOS im Detail?
Zu den Folien dieses Kapitels
10

Asta, Perplexity, Consensus und Scite

  • Wie funktioniert AI2 und was findet man da?
  • Wie funktioniert Asta?
  • Welche Stärken hat Asta?
Zu den Folien dieses Kapitels
11

Von der Recherche zum Text

  • Was macht man mit den verschiedenen Ergebnissen (KI-Tool-Antworten) nach der Recherche?
  • 1. Variante A: Die Volltexte der Papers vergleichen
  • 1. Variante B: Zusammenfassungen der KI-Tools vergleichen
Zu den Folien dieses Kapitels

Prompts und Vorlagen

Eckige Klammern sind Platzhalter. Ergebnisse immer prüfen.

Präziser Rechercheprompt (Beispiel Deskilling durch KI im Studium)

Mit Evidenzmatrix und Trennung von gemessenen Effekten, wahrgenommenen Effekten und Einstellungen.

Recherchiere empirische Literatur (2024 - 2026) zu Deskilling, Downskilling und Cognitive Offloading durch KI im Schul- und Hochschulbereich.
Prüfe in diesem Kontext auch Veränderungen von Schreib-, Recherche-, Problemlöse-, Metakognitions- und Critical-Thinking-Kompetenzen.
Priorisiere europäische Studien, besonders aus dem DACH-Raum und ergänze sie um internationale Evidenz. Erfasse quantitative, qualitative und Mixed-Methods-Studien sowie relevante Reports, Metanalysen und systematische Literature Reviews.
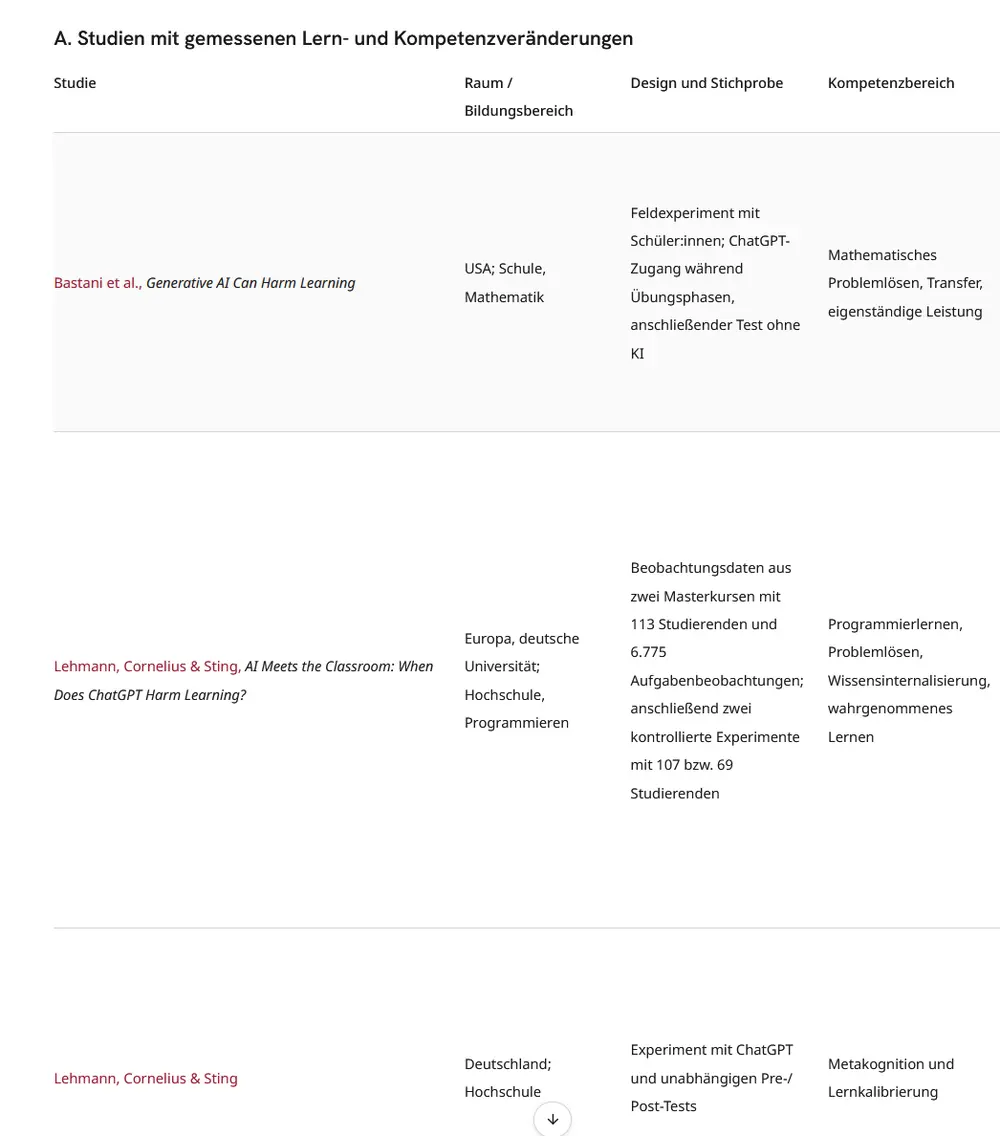
Erstelle eine Evidenzmatrix mit Studiendesign, Stichprobe, Ergebnissen, Evidenzstärke und Limitationen. Trenne konsequent zwischen gemessenen Kompetenzveränderungen, wahrgenommenen Effekten und bloßen Einstellungen gegenüber KI.
Identifiziere Forschungslücken und leite Implikationen für Hochschulen ab.

Reduzierte Fassung für die semantische Suche in OpenAlex

Nur thematische Beschreibung, ohne Formatierungswünsche und Arbeitsanweisungen.

Deskilling, Kompetenzverlust und kognitive Auslagerung durch generative KI bei Schülerinnen, Schülern und Studierenden. Auswirkungen auf Schreiben, Recherche, Problemlösen, Metakognition und kritisches Denken.

Grundlagen: die Folien

Die Inhalte, gegliedert in Kapitel, mit Abbildungen. Ein Klick auf ein Bild öffnet, wo vorhanden, die Quelle.
  1. Ziele und Ausgangslage: Wie KI die Recherche verändert
  2. Halluzinationen und Gegenmittel
  3. Fachbegriffe und Rechercheprompts
  4. Recherche-Infrastruktur und Allzweck-KI (Claude, ChatGPT)
  5. Fachdatenbanken mit KI: Scopus AI und WISO
  6. Google Scholar Labs, OpenAlex und weitere Suchmaschinen
  7. alphaXiv und Wege zur Literatur
  8. KI-Tools im Überblick
  9. scienceOS
  10. Asta, Perplexity, Consensus und Scite
  11. Von der Recherche zum Text
1Ziele und Ausgangslage: Wie KI die Recherche verändert

Vorbemerkungen

  • Die folgenden Folien enthalten meine Ausführungen im Workshop.
  • Die auf den Folien angegeben Links führen entweder zum jeweiligen KI-Tool oder zu Studien, die mir als Quelle meiner Ausführungen gediente haben bzw. weiterführende Informationen zu einem Thema oder einem spezifischen Punkt enthalten.
  • Die generellen Zusammenhänge zwischen KI und Recherche- und Informationskompetenz und die damit verbundenen Veränderungen und Herausforderungen für die Hochschulen habe ich in einem umfangreichen Debattenbeitrag beschrieben, der am 17.08.2026 beim Hochschulforum Digitalisierung veröffentlicht wurde.
  • Sie finden den Text hier: „Vom Google-Dilemma zum KI-Dilemma? Sechs Thesen zur Recherche- und Informationskompetenz an Hochschulen im Angesicht von KI. Ein Debattenbeitrag.“ (Link)

Was sind die Ziele dieser Veranstaltung?

  • Verständnis der grundlegenden wissenschaftlichen Recherche-Infrastruktur wecken
  • Recherche als systematischen, methodisch reflektierten Prozess betreiben
  • wissen, wo innerhalb der Recherche-Infrastruktur KI integriert ist und wo nicht
  • generelles Verständnis von KI-Systemen: Funktionsweise, Chancen, Risiken
  • Kenntnis spezifischer wissenschaftlicher KI-Recherche-Tools und ihrer Funktionen
  • Verbindungen von KI-gestützten Möglichkeiten mit klassischen Suchtechniken zeigen
  • = Ausbildung bzw. Verbesserung der wiss. Informations- und Recherchekompetenz

Wie verändert KI die (wissenschaftliche) Recherche?

  • 60% - 70% der Google-Suchen = sog. zero-click searches (Link)
  • bei ChatGPT werden Links und Quellen in Ergebnissen zu 98%-99% nicht angeklickt (Link)
  • Prüfung und Auseinandersetzung mit den Quellen, Daten und Dokumenten nimmt ab (Link)
  • Nutzer lesen zunehmend nur noch die von KI erzeugte Interpretationsschicht
  • 69% der Studierenden geben an, dass ihnen die Antworten von ChatGPT genügen (Link)
  • Grund: KI-Antworten vermitteln durch ihre kohärente Sprache und schlüssig wirkende Argumentation (sog. processing fluency) Gefühl von Wahrhaftigkeit und Glaubwürdigkeit
  • Vor KI: Hauptproblem = Informationen finden
  • Mit KI: Hauptproblem = KI-Bewertung, Bias-Erkennung, Datengrundlage, Modelllogik usw.
  • KI macht aus dem Suchproblem ein Bewertungsproblem
2Halluzinationen und Gegenmittel

Wie groß ist das Problem der KI-Halluzinationen?

  • Allzweck-KIs wie ChatGPT werden oft zur Recherche genutzt = Gefahr von Halluzinationen
  • KI-Recherche-Tools, die nicht oder nur schwer halluzinieren können, kaum bekannt (s.u.)
  • Folge: zunehmend halluzinierte Quellen in Abschlussarbeiten, Peer-Review-Studien, Konferenzbeiträgen, Handbüchern usw. (Link 1 / Link 2 / Link 3 / Link 4 / Link 5)
Abbildung zu: Wie groß ist das Problem der KI-Halluzinationen?

Quelle der Abbildung: thelancet.com, arxiv.org
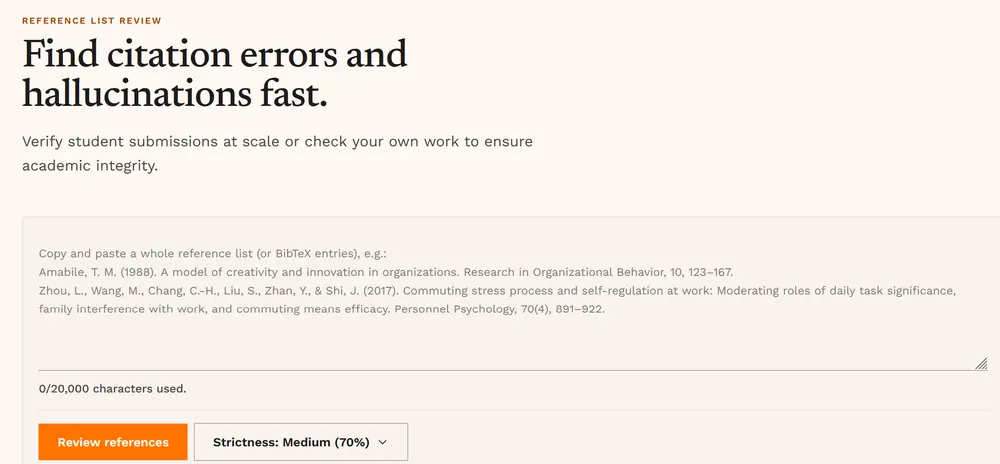
Was kann man gegen KI-Halluzinationen machen?

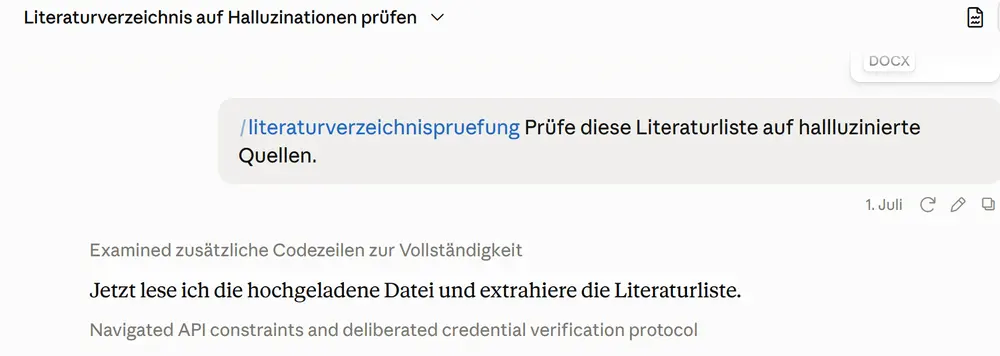
  • Halluzinations-Erkennungs-Programme wie BibFox (Link) nutzen oder
  • einen Halluzinations-Erkennungs-Skill verwenden (Link 1 / Link 2)
  • KI-Systeme können auch „innerhalb“ von Quellen halluzinieren, indem sie Ergebnisse im Laufe eines (längeren) Chats verfälschen (Link) oder sie übermäßig verallgemeinern (Link )
  • Gefundene Quellen und Dokumente immer auf Echtheit prüfen und zudem sicherstellen, welche Inhalte nach mehreren Arbeitsschritten noch aus dem Originaltext stammen
Abbildung zu: Was kann man gegen KI-Halluzinationen machen?

Quelle der Abbildung: bibfox.com, github.com
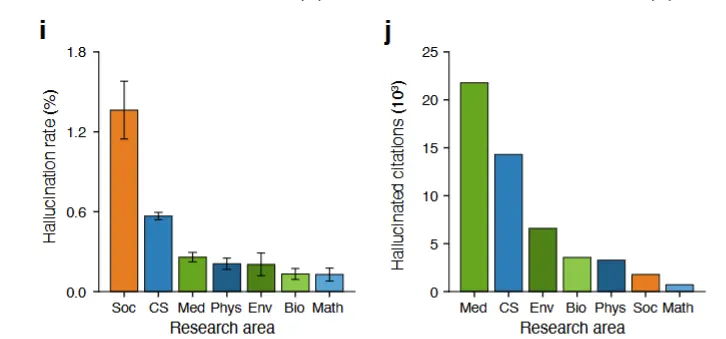
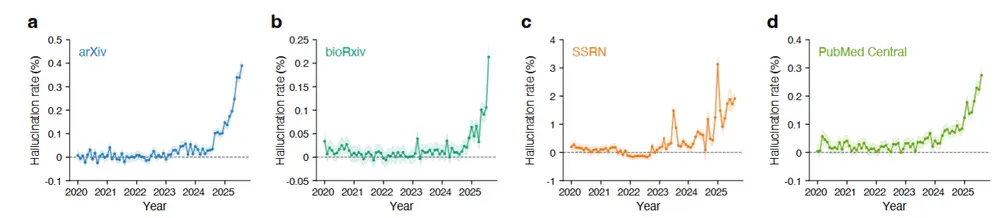
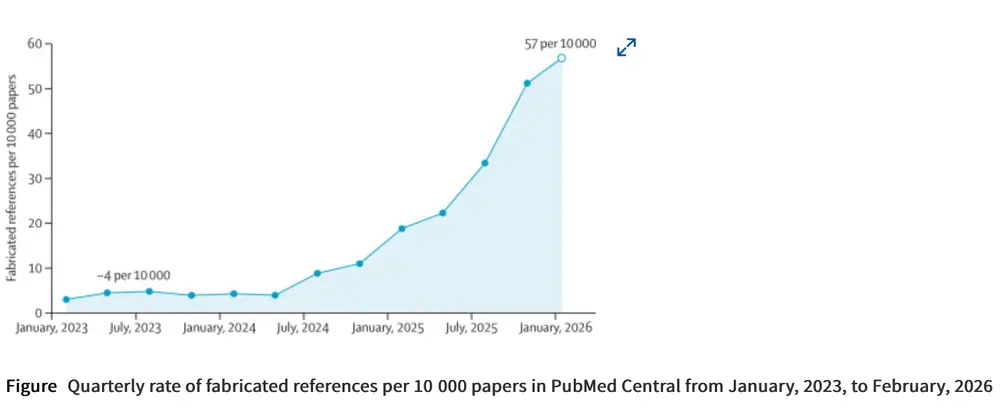
Wie groß ist das Problem der KI-Halluzinationen? Neue Zahlen

  • Studie von Zhao et al. (arXiv, Mai 2026): Geprüft wurden 111 Mio. Referenzen in 2,5 Mio. Papern aus arXiv, bioRxiv, SSRN und PubMed Central (Link)
  • Ergebnis: ein starker Anstieg nicht existierender Referenzen, seit Sprachmodelle breit genutzt werden
  • konservative Schätzung: 146.932 halluzinierte Zitate allein im Jahr 2025
  • Die Fehler konzentrieren sich in Fächern mit schneller KI-Adoption und in Papern mit typischen Merkmalen KI-gestützten Schreibens
  • PubMed Central: Laut einer Abbildung in „The Lancet“ stieg die Rate erfundener Referenzen von rund 4 pro 10.000 Papern (2023) auf 57 pro 10.000 Paper (Anfang 2026) (Link)
  • Heißt für die Praxis: Quellenangaben, die KI liefert, immer einzeln prüfen, auch in veröffentlichten, begutachteten Texten
3Fachbegriffe und Rechercheprompts

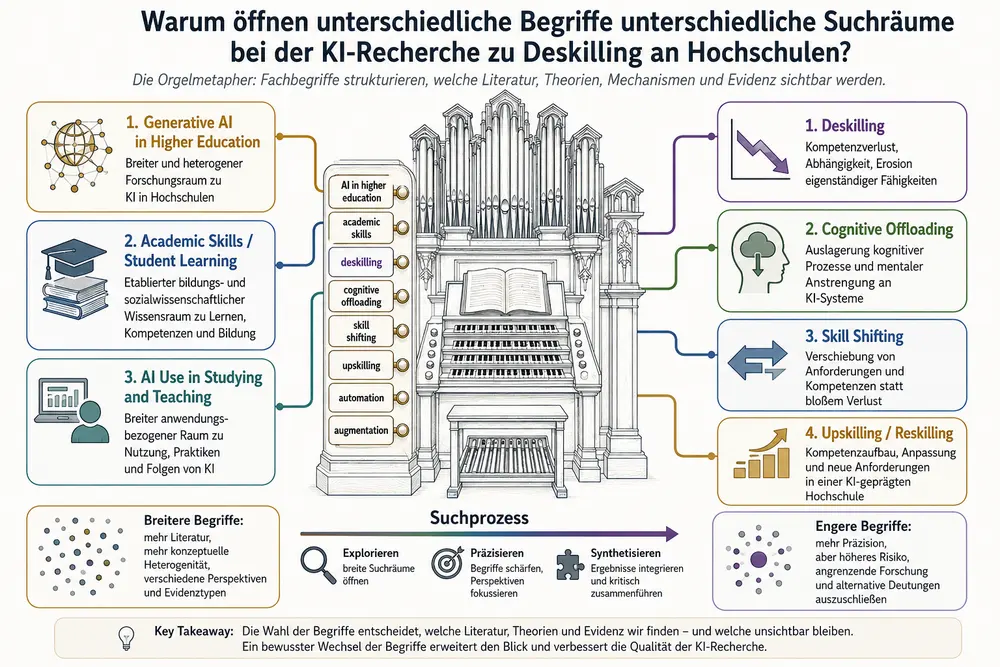
Warum sind und bleiben präzise Fachbegriffe auch bei KI-gestützten Recherchen wichtig?

  • Begriffe wirken wie Register an einer Orgel: Je nachdem, welches Register gezogen wird, verändert sich der Klang – bei KI verändert sich der semantische Suchraum.
  • KI verändert die Suchlogik, aber nicht die Notwendigkeit guter Begriffsarbeit.
  • Welche Treffer erscheinen, hängt zudem von Datenbasis, Indexierung, Suchlogik und Ranking des jeweiligen Systems ab.
  • Abbildung KI-generiert
Abbildung zu: Warum sind und bleiben präzise Fachbegriffe auch bei KI-gestützten Recherchen wichtig?

Warum reicht ein allgemeiner (breiter) Prompt für eine gezielte Recherche nicht aus?

  • Beispielprompt: „Führt der Einsatz generativer KI bei Studierenden zu Deskilling?“
  • Offen bleibt:
  • Was genau bedeutet „Deskilling“? Verlust vorhandener Fähigkeiten, geringerer Kompetenzerwerb, weniger Übung oder stärkere Abhängigkeit von KI?
  • Welche Kompetenzen sind gemeint? Schreiben, wissenschaftliche Recherche, kritisches Denken, Problemlösen, Programmieren oder Fachwissen?
  • Welche Form der KI-Nutzung wird untersucht? Textgenerierung, Recherche, Zusammenfassung, Feedback, Übersetzung oder Problemlösung?
  • Welche Vergleichssituation interessiert? Nutzung mit vs. ohne KI, unterschiedliche Nutzungsintensität oder verschiedene Arten der KI-Unterstützung?
  • Welche Evidenz soll berücksichtigt werden? Experimente, Längsschnittstudien, Beobachtungsstudien, Befragungen, qualitative Studien oder Reviews?
  • Folge des breiten Prompts: Unterschiedliche Kompetenzbegriffe, Wirkmechanismen und Evidenztypen werden vermischt.

Welche Funktionen erfüllt ein breit angelegter Prompt – und welche nicht?

  • Breit angelegter Prompt: „Führt der Einsatz generativer KI bei Studierenden zu Deskilling?“
  • Geeignet, um:
  • zentrale Problemfelder und Fragestellungen zu entdecken
  • einen ersten Überblick über das Forschungsfeld zu gewinnen.
  • Nicht geeignet, um
  • wissenschaftlicher Evidenz gezielt zu prüfen
  • ein Thema differenziert und umfassend zu erschließen
  • Breit angelegte Prompts kartieren ein Forschungsfeld, präzise Prompts strukturieren dagegen die Evidenzsuche.

Was muss vor einer wissenschaftlichen Recherche mit (und ohne) KI geklärt werden?

Mögliche DimensionLeitfrageBeispiel
GegenstandWas genau wird untersucht?Nutzung generativer KI im Studium
ZielgruppeWer wird untersucht?Studierende
KompetenzbereichWelche Fähigkeiten interessieren?Schreiben, Problemlösen, Recherche …
Art der KI-NutzungWofür wird KI eingesetzt?Textproduktion, Datenanalyse, Visuals…
WirkmechanismusWie kann KI Kompetenz beeinflussen?Cognitive Offloading, Automatisierung etc.
ZielgrößeWas soll beobachtet werden?Prüfungsergebnisse, Lernerfolg usw.
EvidenztypWelche Belege zählen?Experimente, Längsschnittstudien etc.
GeltungsbereichUnter welchen Bedingungen gelten die Ergebnisse?Fach, Aufgabenart, Nutzungsintensität…
AlternativerklärungenWas muss zusätzlich geprüft werden?Skill Shifting, Kompetenzgewinn usw.

Welche Funktionen erfüllt ein mehrdimensionaler und zugleich präziser Rechercheprompt?

  • Rechercheprompt:
  • Recherchiere empirische Literatur (2024 - 2026) zu Deskilling, Downskilling und Cognitive Offloading durch KI im Schul- und Hochschulbereich.
  • Prüfe in diesem Kontext auch Veränderungen von Schreib-, Recherche-, Problemlöse-, Metakognitions- und Critical-Thinking-Kompetenzen.
  • Priorisiere europäische Studien, besonders aus dem DACH-Raum und ergänze sie um internationale Evidenz. Erfasse quantitative, qualitative und Mixed-Methods-Studien sowie relevante Reports, Metanalysen und systematische Literature Reviews.
  • Erstelle eine Evidenzmatrix mit Studiendesign, Stichprobe, Ergebnissen, Evidenzstärke und Limitationen. Trenne konsequent zwischen gemessenen Kompetenzveränderungen, wahrgenommenen Effekten und bloßen Einstellungen gegenüber KI.
  • Identifiziere Forschungslücken und leite Implikationen für Hochschulen ab.
Bestandteil des PromptsWarum steht das darin?
„empirische Literatur“Verhindert, dass theoretische oder konzeptuelle Arbeiten dieselbe Bedeutung bekommen wie empirische Studien.
„2024 - 2026“Grenzt Forschungsfeld zeitlich ein.
„Deskilling, Downskilling und Cognitive Offloading“Verwandte Konstrukte öffnen verschiedene wissenschaftl. Diskurse. Würde nur „Deskilling“ gesucht, könnte relevante Literatur über Cognitive Offloading fehlen.
„Schul- und Hochschulbereich“Definiert den Anwendungskontext.
Bestandteil des PromptsWarum steht das darin?
Schreiben, Recherche, Problemlösen, Metakognition, Critical ThinkingOperationalisiert These „KI macht uns weniger kompetent“ in messbare bzw. beobachtbare Kompetenzdimensionen.
Europa / DACH und internationale EvidenzVerbindet Kontextnähe mit größerer Evidenzbasis. Nur DACH wäre evtl. zu wenig, nur internationale Literatur evtl. schlecht auf deutsche Hochschulen übertragbar.
quantitativ, qualitativ, Mixed Methods, Reviews usw.Verhindert methodische Monokultur, erlaubt Triangulation.
EvidenzmatrixBringt KI-System weg von rein narrativer Zusammenfassung hin zu einem strukturierten Vergleich der Studien.
Bestandteil des PromptsWarum steht das darin?
Studiendesign, Stichprobe, Evidenzstärke, LimitationenErgebnisse werden nicht nur gesammelt, sondern hinsichtlich ihrer Aussagekraft bewertet.
gemessene Veränderungen vs. wahrgenommene Effekte vs. EinstellungenBei KI basieren viele Daten auf Umfragen und Selbsteinschätzungen, aber wenig auf echten Kompetenz-Messungen – das verhindert, dass das vermischt wird
Forschungslücken und HochschulimplikationenFührt von „Was wissen wir?“ zu „Was wissen wir noch nicht?“ und leitet Konsequenzen für Hochschulen. Ab
  • ABER: Auch ein guter Rechercheprompt führt nur dann zu validen Ergebnissen, wenn dafür die jeweils geeigneten wissenschaftlichen Recherche-Plattformen genutzt werden. ⟶ ⟶ ⟶
4Recherche-Infrastruktur und Allzweck-KI (Claude, ChatGPT)

Wie sieht die wissenschaftliche Recherche-Infrastruktur (ungefähr) aus?

  • In der Abbildung gelb markiert sind KI-Integrationen in „klassische“ Plattformen bzw. genuine KI-Tools.
  • Die Abbildung wurde mit Mermaid.ai (Link) auf Basis eigener Notizen und Daten erstellt.

Warum fehlen ChatGPT, Gemini, Claude und Co in der Recherche-Übersicht?

  • ChatGPT, Claude, Gemini und Co. können wissenschaftliche Recherche unterstützen (z.B. durch Deep Research), sind aber keine genuin wissenschaftlichen Plattformen
  • Qualität ihrer Ergebnisse hängt von angebundenen Datenquellen, verfügbaren Funktionen und Zugriffsrechten ab
  • aber: Zugriff auf wissenschaftliche Datenbanken oft eingeschränkt bzw. setzt institutionellen Zugang und technische Integrationen voraus
  • ChatGPT, Claude usw. können durch Plugins und Konnektoren mit KI-Recherche-Tools verbunden und durch „Skills“ bzw. Arbeitsanweisungen zu komplexen Recherche-Pipelines erweitert werden
  • solche Workflows können – abhängig von Zugriff, Konfiguration, Datenbankanbindung und Nutzungslimit – mehrere Datenbanken durchsuchen, Treffer bewerten und Ergebnisse synthetisieren

Wie kann ich eine „Allzweck-KI“ wie Claude für die wissenschaftliche Recherche nutzen?

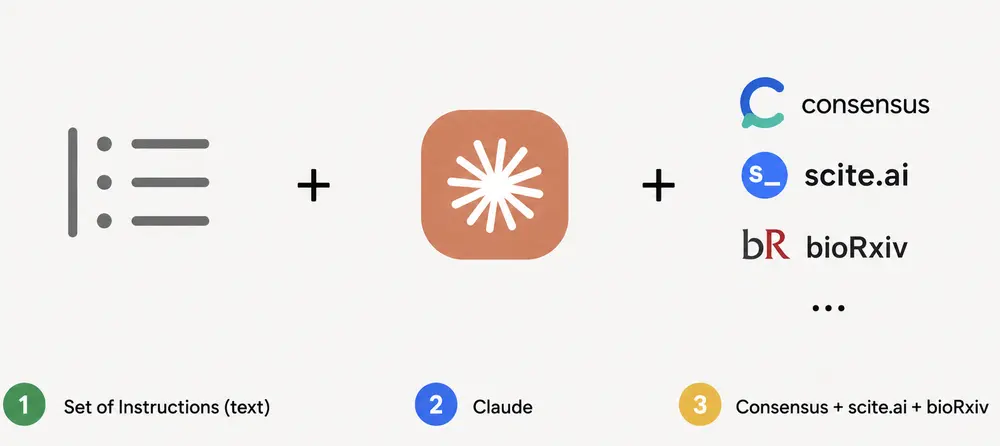
  • Strukturierte Recherche-Pipeline aus:
  • LLM (Claude)
  • Literatur Search Skill (z.B. hier) – ggf. auf Fach und relevante Datenbanken usw. anpassen
  • Konnektor, z.B. Consensus (Link), scite.ai (Link) oder bioRxiv (Link)
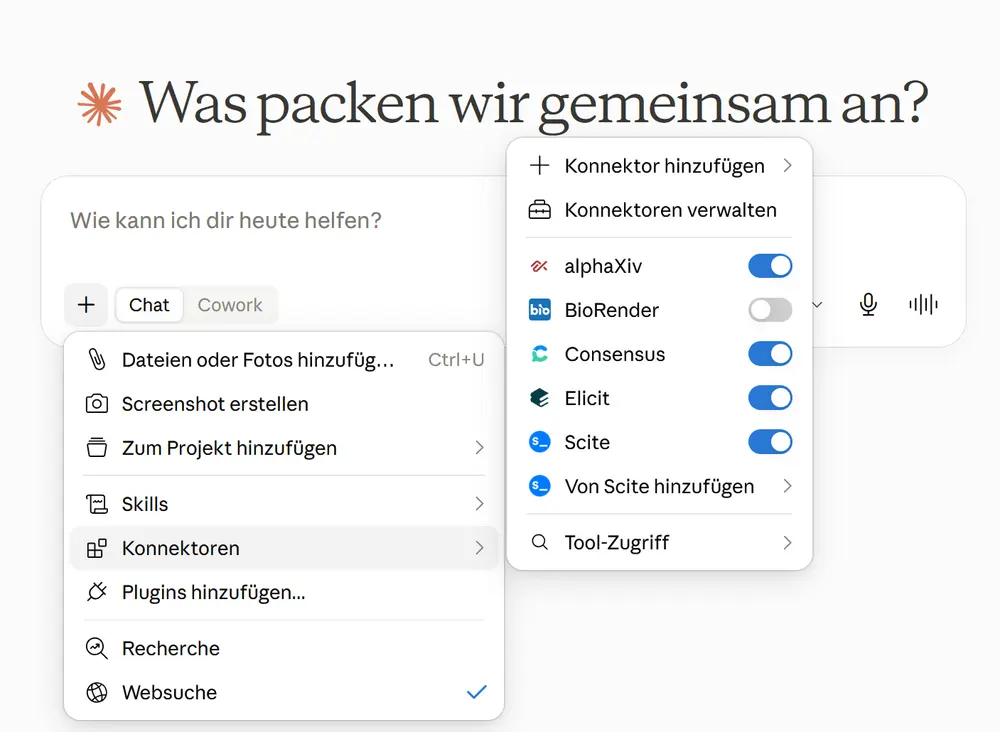
Abbildung zu: Wie kann ich eine „Allzweck-KI“ wie Claude für die wissenschaftliche Recherche nutzen?
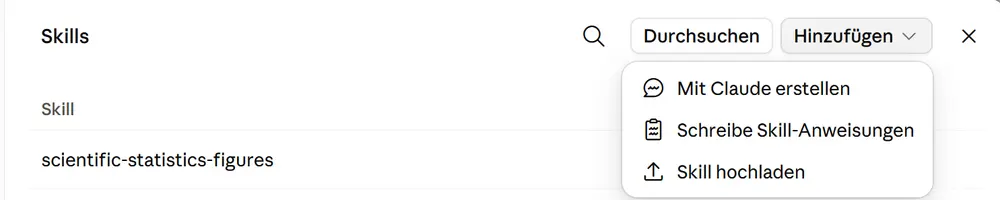
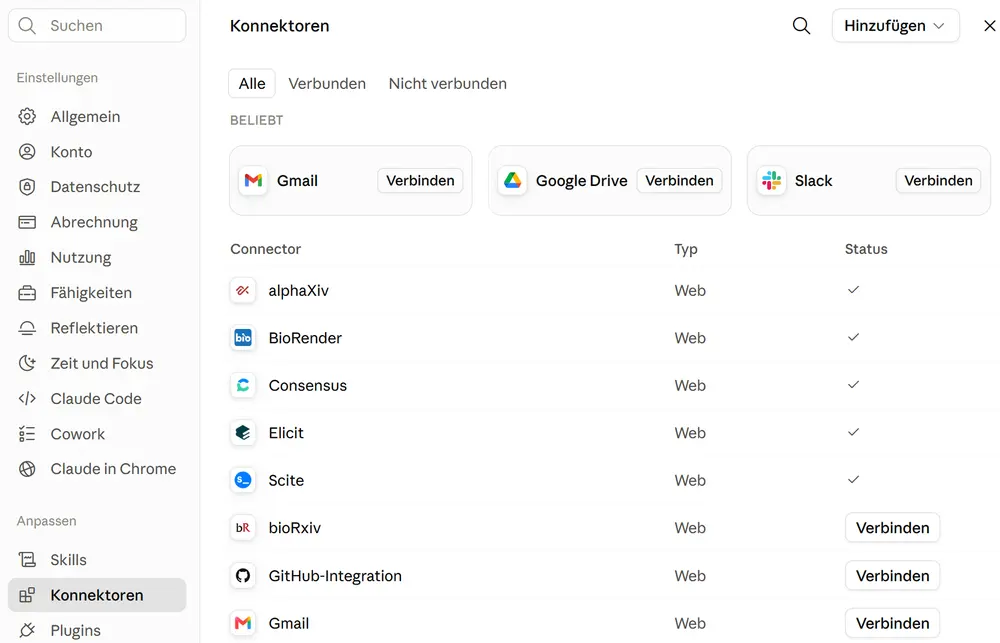
  • Skills können über „Fähigkeiten“ verwalten“ gesucht, hinzugefügt, selbst verfasst oder mit Hilfe von Claude erstellt werden
Abbildung zu: Wie kann ich eine „Allzweck-KI“ wie Claude für die wissenschaftliche Recherche nutzen?

Wie kann ich „Allzweck-KI“-Systeme wie Claude oder ChatGPT für die wiss. Recherche nutzen?

  • Claude ist die ausführende KI: liest, vergleicht, extrahiert, synthetisiert
  • Skill ist die Methode: legt fest, wie recherchiert wird, z.B. Suchstrategie, Einschlusskriterien, Screening, Qualitätsbewertung usw.
  • Konnektor ist der Zugang zum Korpus: z.B. Consensus, scite.ai, alphaXiv usw.
  • Problem: volle Leistung nur mit Abos möglich, selbst Claude Pro reicht oft nicht aus
  • Zudem: Konnektoren finden nur, worauf sie Zugriff haben ⟶ fehlende Domains oder gesperrte Datenbanken erzeugen blinde Flecken
  • Skills müssen klar sein ⟶ unscharfe Arbeitsanweisungen führen zu zufälligem Screening
  • mehr Treffer bzw. Quellen bedeuten nicht automatisch bessere Ergebnisse → mehr Dubletten, irrelevante Treffer und höherer Screening-Aufwand
  • Menschliche Expertise bleibt entscheidend bei Recherche, Datenbankauswahl, Bewertung der Studienqualität, Interpretation der Evidenz, Prüfung der Quellen

Worauf muss ich beim Einsatz von Konnektoren bei Claude achten?

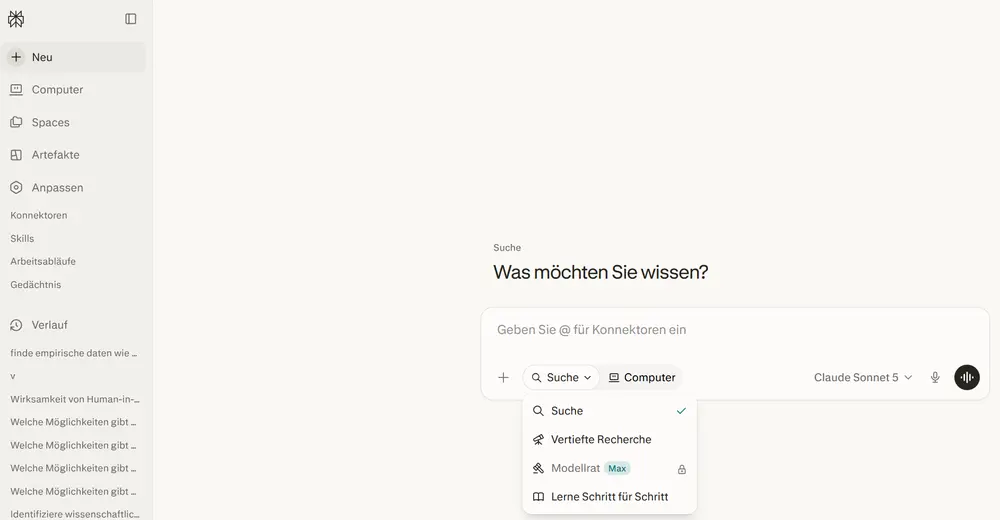
  • Problem: Konnektoren werden bei Claude nicht automatisch bei jeder Suche einbezogen, auch wenn sie verbunden sind  Lösung: Konnektoren im Prompt erwähnen.
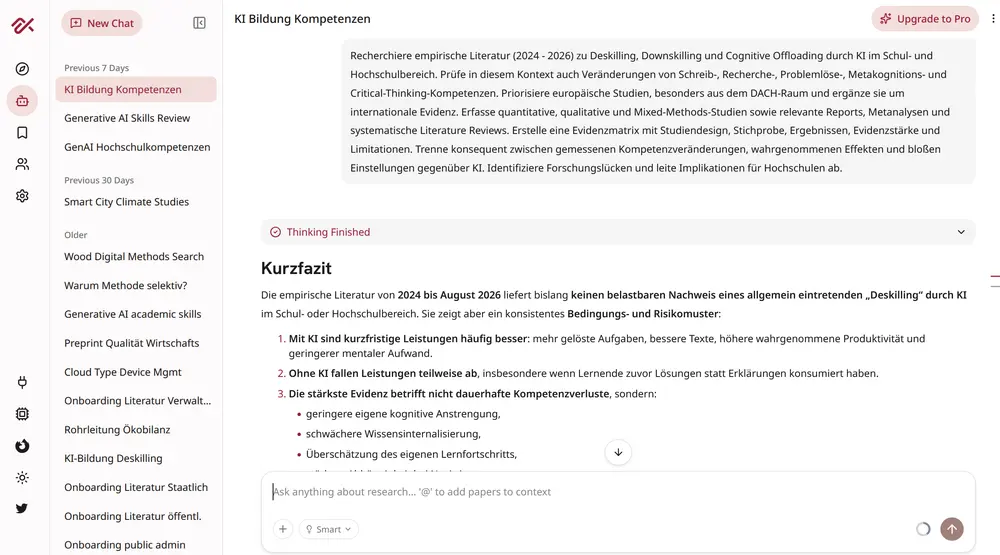
  • Beispiel: Recherchiere empirische Literatur (2024 - 2026) zu Deskilling, Downskilling und Cognitive Offloading durch KI im Schul- und Hochschulbereich. Prüfe in diesem Kontext auch Veränderungen von Schreib-, Recherche-, Problemlöse-, Metakognitions- und Critical-Thinking-Kompetenzen. Priorisiere europäische Studien, besonders aus dem DACH-Raum und ergänze sie um internationale Evidenz. Erfasse quantitative, qualitative und Mixed-Methods-Studien sowie relevante Reports, Metanalysen und systematische Literature Reviews. Erstelle eine Evidenzmatrix mit Studiendesign, Stichprobe, Ergebnissen, Evidenzstärke und Limitationen. Trenne konsequent zwischen gemessenen Kompetenzveränderungen, wahrgenommenen Effekten und bloßen Einstellungen gegenüber KI. Identifiziere Forschungslücken und leite Implikationen für Hochschulen ab. Nutze zusätzlich meine Konnektoren: Consensus, Elicit, alphaXiv, Scite.ai, Paperguide, Undermind und alle weiteren Recherche-Tools. Gib mir deren Treffer jeweils gesondert aus.

Wie kann ich eine „Allzweck-KI“ wie ChatGPT für die wissenschaftliche Recherche nutzen?

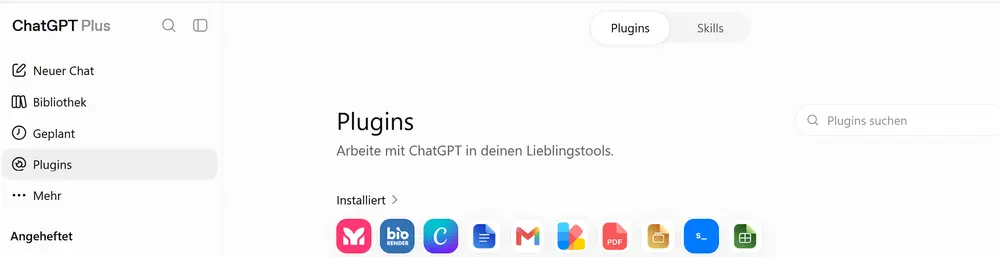
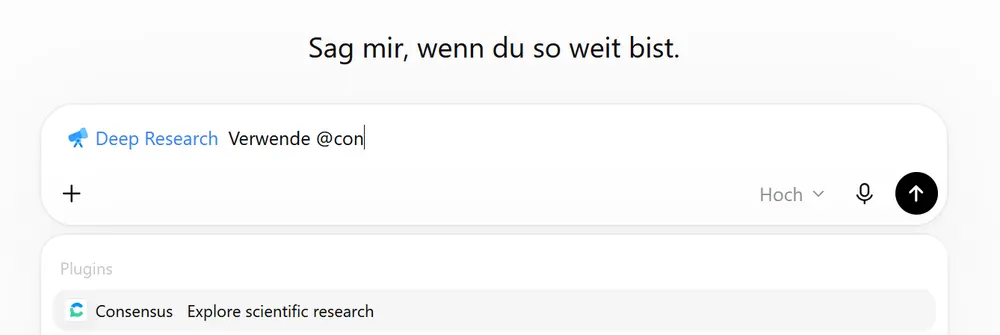
  • In ChatGPT können KI-Recherche-Tools wie Scite, Consensus, Elicit, SciSpace u.a. als Plugin dazugeschaltet werden. Es ist jeweils ein Account für diese KI-Tools nötig. Ein Freemium-Account ist ausreichend – und auch wenn dann nicht die vollen Funktionen und Suchtumfänge bzw. Suchtiefen der Tools genutzt werden können, ist die Recherche-Leistung dennoch deutlich besser als ohne diese Plugins.
Abbildung zu: Wie kann ich eine „Allzweck-KI“ wie ChatGPT für die wissenschaftliche Recherche nutzen?
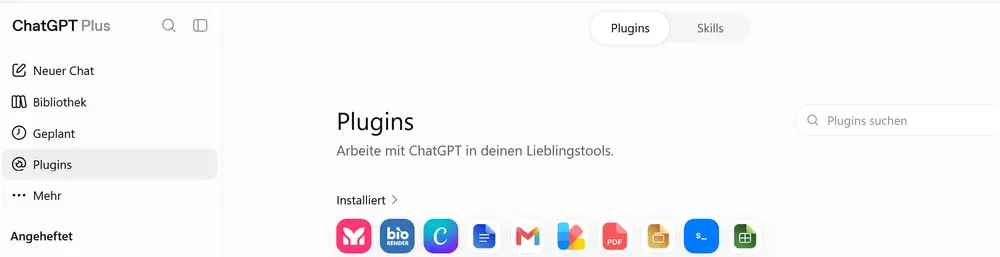
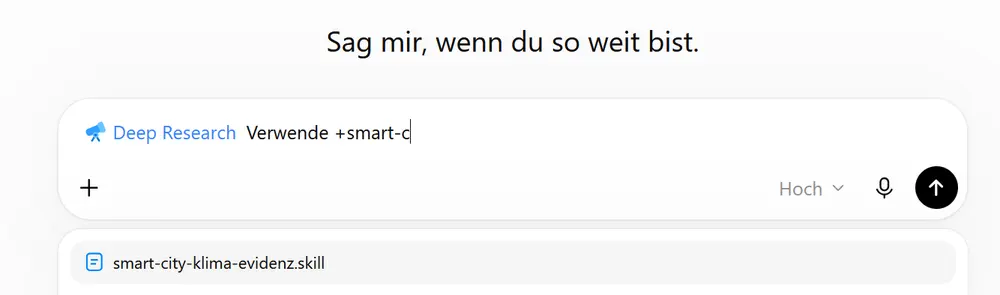
  • In ChatGPT können auch Skills definiert werden, z.B. ein Skill zur Literaturrecherche.
  • Am stärksten ist eine Recherche, die Plugins und einen (fachspezifischen) Literatur-Recherche-Skill verwendet.
Abbildung zu: Wie kann ich eine „Allzweck-KI“ wie ChatGPT für die wissenschaftliche Recherche nutzen?

Worauf muss ich beim Einsatz von Plugins und Skills bei ChatGPT achten?

  • Problem: Plugins und Skills werden bei ChatGPT nicht automatisch bei jeder Suche einbezogen, auch wenn sie verbunden sind
  • Lösung: Plugins und Skills im Prompt erwähnen oder mit @ bzw. + im Prompt einfügen
Abbildung zu: Worauf muss ich beim Einsatz von Plugins und Skills bei ChatGPT achten?

Wie kann ich die Claude Science App für eine wissenschaftliche Recherche nutzen?

  • Claude Science ist die ausführende Forschungsumgebung: Sie recherchiert Literatur, analysiert Daten, führt Code aus und dokumentiert Arbeitsschritte nachvollziehbar
  • Skills standardisieren wissenschaftliche Workflows, z. B. Datenaufbereitung, Qualitätskontrolle oder definierte Analyseverfahren. Dadurch können wiederkehrende Abläufe konsistenter ausgeführt werden
  • Konnektoren / MCPs geben Zugang zu wissenschaftlichen Quellen und Tools, z. B. PubMed
  • Analyse und Recherche können verbunden werden: Claude kann Literatur synthetisieren, Widersprüche zwischen Studien identifizieren und Ergebnisse mit Datenanalysen verknüpfen
  • Problem: Die Qualität hängt auch hier vom Zugang zu Datenbanken und Quellen ab. Nicht verfügbare oder nicht verbundene Literatur kann zu systematischen blinden Flecken führen
  • Automatisierte Recherche ist nicht automatisch systematische Recherche: Suchstrategie, Ein- und Ausschlusskriterien usw. müssen vorgegeben und dokumentiert werden
  • Quellenangaben, Code und Audit-Trails erleichtern die Prüfung. Wissenschaftliche Aussagen müssen trotzdem anhand der Originalquellen kontrolliert werden

Was leistet Claude Science im Vergleich zu Claude mit Skills und Konnektoren?

BereichReguläres Claude (Chat)Claude Science (App)
Wer bringt welche Skills mit?Nur Ihre Skills. Das System ist leer. Es weiß nur das, was Sie ihm im Chat als Text-Anweisung (Prompt) beibringen.Beide zusammen (das Optimum). Claude Science bringt über 60 wissenschaftliche Fach-Skills mit (z. B. für Biologie, Chemie, Tabellen-Analyse) und bettet Ihre eigenen Skills nahtlos ein.
Wie werden Ihre Skills verarbeitet?Als Text-Vorgabe. Claude liest Ihre Regeln (z. B. „Prüfe die Statistik nach Methode X“) und versucht, sich beim Schreiben im Chat daran zu halten.Als echtes Werkzeug. Claude Science liest Ihre Regeln und schreibt ein Computer-Programm (z. B. in Python), um Ihre Methode mathematisch exakt auszuführen.
Merkfähigkeit Ihrer SkillsFlüchtig. Je länger der Chat und je mehr PDFs Sie hochladen, desto eher „vergisst“ Claude Ihre Skills oder weicht von den Regeln ab.Dauerhaft gespeichert. Ihre Skills werden als feste Werkzeuge in der Workbench hinterlegt und bleiben über die gesamte Recherche hinweg stabil.
Weiterentwicklung Ihrer SkillsManuell. Wenn Sie Ihre Arbeitsweise verbessern wollen, müssen Sie Ihren Text-Prompt jedes Mal selbst umschreiben und neu hineinkopieren.Automatisch lernend. Wenn Sie einen erfolgreichen Recherche-Weg finden, kann Claude Science daraus selbstständig einen neuen, dauerhaften Skill erstellen und für die nächste Arbeit abspeichern.
5Fachdatenbanken mit KI: Scopus AI und WISO

Wie funktioniert ScopusAI (Link)?

  • ScopusAI ist die KI-Suche der Scopus-Datenbank (mehr zu Scopus AI hier von mir)
  • Zugang zu Scopus aus Campusnetz lizenziert bzw. per VPN
  • Scopus enthält 100 Mio. Dokumente: Abstracts, Preprints, Artikel, Konferenzbeiträge etc.
  • ca. 2,5 Milliarden Zitationen aus ca. 28.000 Peer-Review-Journale
  • Suche kann in natürlicher Sprache und auch auf Deutsch erfolgen
  • Deep Research verwenden, um mehr Treffer zu bekommen
  • Suche mit „Cited by, Autorenprofilen und verschiedenen Scopus-Metriken erweitern bzw Suchergebnisse damit bewerten
  • Aber: selber Prompt am selben Computer = unterschiedliche Ergebnisse (Link)

Warum ist eine einzelne KI-Recherche kein reproduzierbares Endergebnis?

  • KI-Recherchetools können bei ähnlichen oder sogar identischen Anfragen unterschiedliche Quellen auswählen, gewichten und zusammenfassen.
  • Systeme kombinieren semantische Ähnlichkeit, Keywords, Zitationsdaten, Filter und Ranking immer wieder unterschiedlich
  • Suchschritte, Auswahl-Entscheidungen und Synthesen können von Suchlauf zu Suchlauf variieren.
  • Konsequenz für die Praxis
  • Recherche mit demselben Prompt mehrfach durchführen
  • prüfen, ob zusätzliche Suchen noch relevante neue Literatur liefern
  • Formulierungen und Suchbegriffe variieren
  • neue und wiederkehrende Treffer (mit KI) vergleichen
  • Ergebnisse mit klassischen Suchwegen und Citation Tracking ergänzen

Wie funktioniert ScopusAI?

EbeneBeschreibung
Datenbank- und OrganisationslogikBibliografische Abstract- und Zitationsdatenbank mit 100 Mio. Dokumenten und 2,5 Milliarden Zitationen aus 28.000 Peer-Review-Journalen, jedes Dokument hat bis zu180 Datenpunkte
SuchlogikKlassisches Information-Retrieval über Schlagwörter, Boolesche Operatoren, Filter, Zitationssuche und kontrollierte Metadaten
ZitationslogikPublikationen werden über Zitationsnetzwerke verknüpft
NetzwerklogikAutoren, Institutionen, Journale und Themen werden verbunden
RankinglogikErgebnisse nach Relevanz, Zitierungen, Aktualität usw. gewichtet

Welche Grenzen und Einschränkungen hat ScopusAI?

GrenzeErklärung
Keine vollständige AbdeckungScopus ist nur eine Datenbank unter vielen, wenngleich eine große
Kaum Bücher und MonografienFokus liegt stark auf wissenschaftlichen Journalartikeln
Englischsprachige Forschung dominiertdeutschsprachige und regionale Literatur wenig vertreten
Graue Literatur kaum sichtbarz.B. Reports, Abschlussarbeiten oder viele Repositorien fehlen
Meist keine Volltexte bzw. „nur“ über externe Links zugänglichScopus enthält v.a. Metadaten, Abstracts usw.
Komplexe Suchlogikgute Ergebnisse erfordern auch bei KI präzise Suchbegriffe und Prompts
Gefahr enger Rechercheblasenstarke Orientierung an Schlagwörtern und Zitierungsnetzwerken

Wo können Verzerrungen (Biases) bei KI-gestützten Recherchen entstehen?

  • Datenbasis und Abdeckung: Englischsprachige Journals und gut indexierte Publikationen sind überrepräsentiert. Monografien, Normen und graue Literatur kommen seltener vor. Auch deutschsprachige Forschung und regional bezogene Arbeiten sind deutlich seltener.
  • Indexierung und Metadaten: Ein System findet nur, was in seinem Korpus vorhanden und gut erschlossen ist. Fehlerhafte oder fehlende Metadaten erzeugen blinde Flecken.
  • Retrieval und Ranking: Semantische Ähnlichkeit, Zitationszahlen und Popularitätssignale können bestimmte Themen, Positionen, Journals und Autoren bevorzugen.
  • Generative Synthese: KI-Zusammenfassungen können methodische Unterschiede, Limitationen und Gegenbefunde einebnen und Befunde zu sehr verallgemeinern
  • Transparenz und Reproduzierbarkeit: Korpus, Ranking, Modellversion und Auswahlentscheidungen der KI-Systeme sind oft nur begrenzt nachvollziehbar.
  • Konsequenzen:
  • Verschiedene Recherchesysteme kombinieren.
  • Klassische Systeme wie OPACs und Fachdatenbanken bleiben unverzichtbar, weil sie z.T. andere Bestände und Publikationstypen erschließen und ihre Suchlogik besser steuerbar ist.

Wie funktioniert der KI-Assistent in wiso-net.de (Link)?

  • KI-gestützter Rechercheassistent innerhalb der WISO-Fachdatenbank
  • Erreichbar aus dem Campusnetz bzw. via VPN
  • Schwerpunkt: Wirtschafts- und Sozialwissenschaften
  • natürliche Sprache statt klassischer Suchsyntax
  • analysiert und verdichtet Inhalte aus dem lizenzierten WISO-Datenraum
  • arbeitet primär mit kuratierten Quellen (eBooks, Fachzeitschriften, Presse, Studien usw.)
  • direkte Verlinkung zu Originaldokumenten
  • Basis: Retrieval Augmented Generation (RAG)-Architektur
  • KI-Schicht vermittelt zwischen Nutzer und Dokument
  • KI-Assistent senkt Einstiegshürden klassischer Datenbankrecherche

Welche Stärken hat der KI-Assistent in wiso-net?

  • Quellentransparenz: Jede Aussage ist mit Originaldokumenten verlinkt
  • dadurch keine Gefahr von erfundenen Quellen
  • Wissensraum aus Wissenschaft + Praxis + Medien
  • neben wissenschaftlichen Büchern und Studien sind auch (Fach-)Zeitungen mit abgedeckt - gut für aktuelle Infos, Praxisberichte usw.
  • primär deutschsprachig bzw. Quellen aus dem DACH-Raum
  • einfacher Einstieg ohne komplexe Suchsyntax
  • schnelle Orientierung in großen Dokumentmengen durch KI-Zusammenfassung
  • Kombination aus Datenbankqualität und KI-Komfort

Welche Schwächen hat der KI-Assistent in wiso-net?

  • Schwerpunkt auf deutschsprachige Quellen und Dokumente
  • unklare KI-Gewichtungs- und Auswahlprozesse
  • Zusammenfassungen reduzieren Komplexität und methodische Details
  • Keine follow-up-Fragen möglich
  • Publicationbias und Verzerrung durch Zeitfilter: „KI-Antworten basieren aktuell auf Dokumenten aus den Medienarten Presse, Fachpresse und Publikumspresse ab 01.01.2023“ (Link)
  • Gefahren (wie bei jedem KI-System): oberflächliche Rezeption der Ergebnisse, Verlust aktiver Quellenarbeit, Antwortzufriedenheit
6Google Scholar Labs, OpenAlex und weitere Suchmaschinen

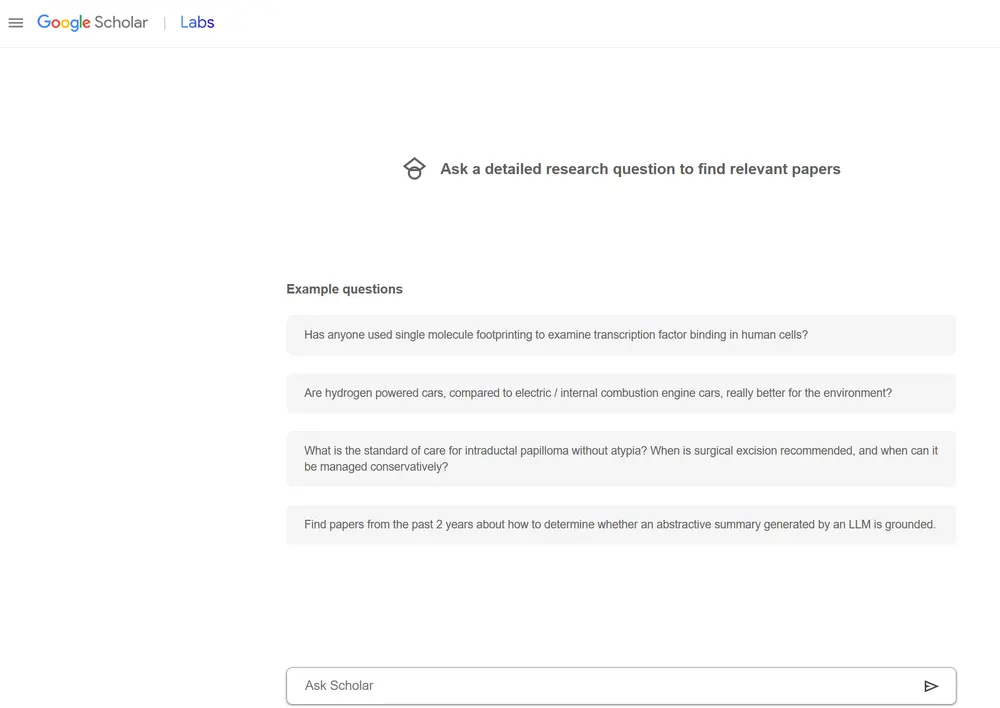
Google Scholar Labs

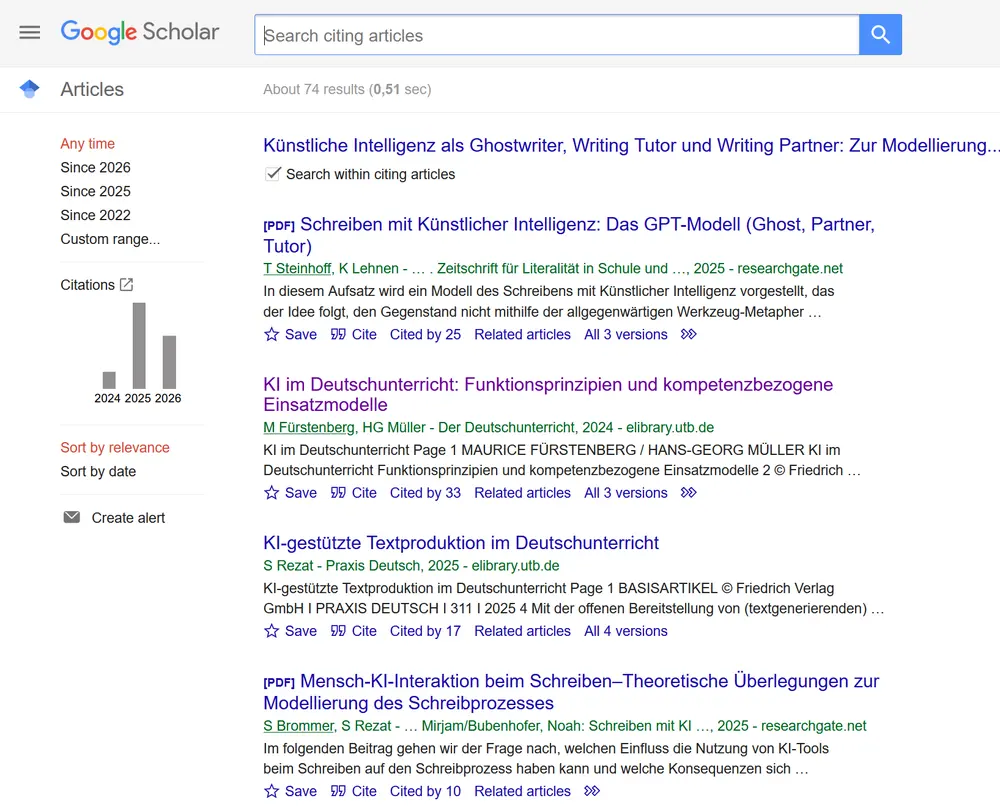
Abbildung zu: Google Scholar Labs (Link)

Wie funktioniert Google Scholar Labs?

  • experimentelle KI-Erweiterung von Google Scholar
  • natürliche Sprache statt klassischer Schlagwortsuche
  • analysiert und erkennt zentrale Themen, Aspekte, Beziehungen  sucht dann im Google-Scholar-Index
  • Ranking bewertet Papers nach Relevanz für die Forschungsfrage
  • Semantische Analyse des Prompts
  • LLM erzeugt Kurzzusammenfassung
  • Filter nur über Prompts möglich
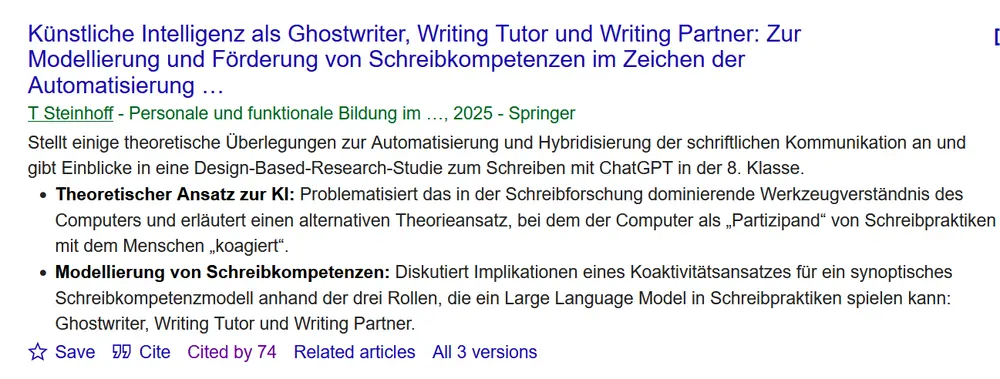
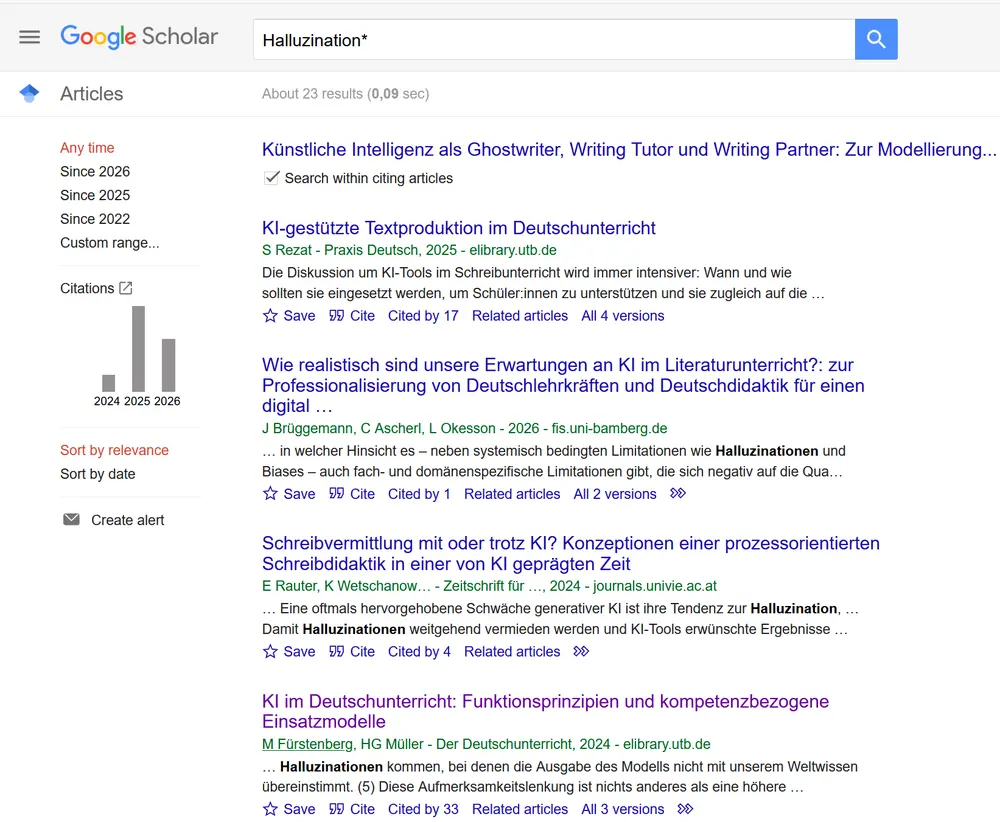
  • Labs enthält die von Google Scholar bekannten Funktionen wie Forward Citation Tracking (siehe dazu die nächste Folie und meine Ausführungen hier, Link)

Abbildung zu: Abbildung

Welche Stärken und Schwächen hat Google Scholar Labs?

  • Stärken
  • natürliche Sprache statt Suchsyntax
  • Suchen werden automatisch übersetzt
  • basiert auf dem sehr großen Google-Scholar-Datenraum
  • Follow-up-Fragen ermöglichen Vertiefungen und Filter
  • hilfreich, wenn Fachbegriffe unklar / unbekannt / variabel
  • Schwächen
  • Ranking- und Modelllogik weitgehend Black Box
  • unklar, wie Papers genau gewichtet werden
  • wichtige Studien können fehlen
  • Qualität der KI-Zusammenfassungen gering

Welche wissenschaftlichen Suchmaschinen gibt es noch?

  • BASE (Link)
  • OpenAIRE (Link)
  • CORE (Link)
  • Matilda (Link)
  • Livivo (Link)
  • OpenAlex (Link)
  • Diese Suchmaschinen und Plattformen haben zwar – bis auf OpenAlex – (noch) kein KI integriert, sind aber für die Recherche zu empfehlen, da sie:
  • hunderte Millionen Dokumente indexiert und zum Großteil auch im Volltext haben
  • viel Literatur und Daten beinhalten, die sonst nur schwer oder gar nicht zu finden ist, z.B. Bachelor- und Masterarbeiten, Dissertationen, Forschungsberichte, Working-Papers usw.

Wie unterscheiden sich die Boolesche und die semantische Suche in OpenAlex?

Boolesche SucheSemantische Suche
Liefert auf Grundlage festgelegter Suchbegriffe eine größere Ergebnismenge.Liefert die 50 Publikationen, die inhaltlich bzw. semantisch am ähnlichsten sind.
Unterstützt Filtern und Facettieren der Ergebnisse durch Jahr, Publikationstyp, Thema usw.Noch kein Filtern / Facettieren möglich.
Bietet mehr Kontrolle und Reproduzierbarkeit.Ermöglicht die Entdeckung relevanter Inhalte unabhängig von exakter Wortwahl.
Eignet sich für gezielte und strukturierte Suchanfragen.Eignet sich für die explorative Suche und das Auffinden relevanter Fachbegriffe.
Kann alternative Formulierungen u. Synonyme übersehen.Kann konzeptionell verwandte, aber weniger relevante Publikationen zurückgeben.

Welche Schwierigkeiten gibt es beim Prompting in der OpenAlex Semantic Search (Beta)?

  • Problem:
  • Rechercheprompt („Recherchiere wissenschaftliche Literatur…“) überfordert die semantische Such-API von OpenAlex
  • Wenn man komplexen Prompt einfügt, „verwaschen“ die Befehle den thematischen Kern
  • Semantische OpenAlex-Suche versteht thematische Beschreibungen, aber keine komplexen Arbeitsanweisungen
  • Metaanweisungen, Ausschlüsse und formale Bedingungen in Filter / separate Suchschritte
  • Lösung:
  • rein thematische Beschreibung ohne Formatierungswünsche nutzen
  • „Deskilling, Kompetenzverlust und kognitive Auslagerung durch generative KI bei Schülerinnen, Schülern und Studierenden. Auswirkungen auf Schreiben, Recherche, Problemlösen, Metakognition und kritisches Denken.“ (Link 1 komplex / Link 2 reduziert)
  • OpenAlex findet viel graue Literatur, die z.T. nicht mal bei Google Scholar indiziert ist

Wie unterscheiden sich die Boolesche und die semantische Suche in OpenAlex?

  • Citation Tracking (Forward / Backward) nutzen
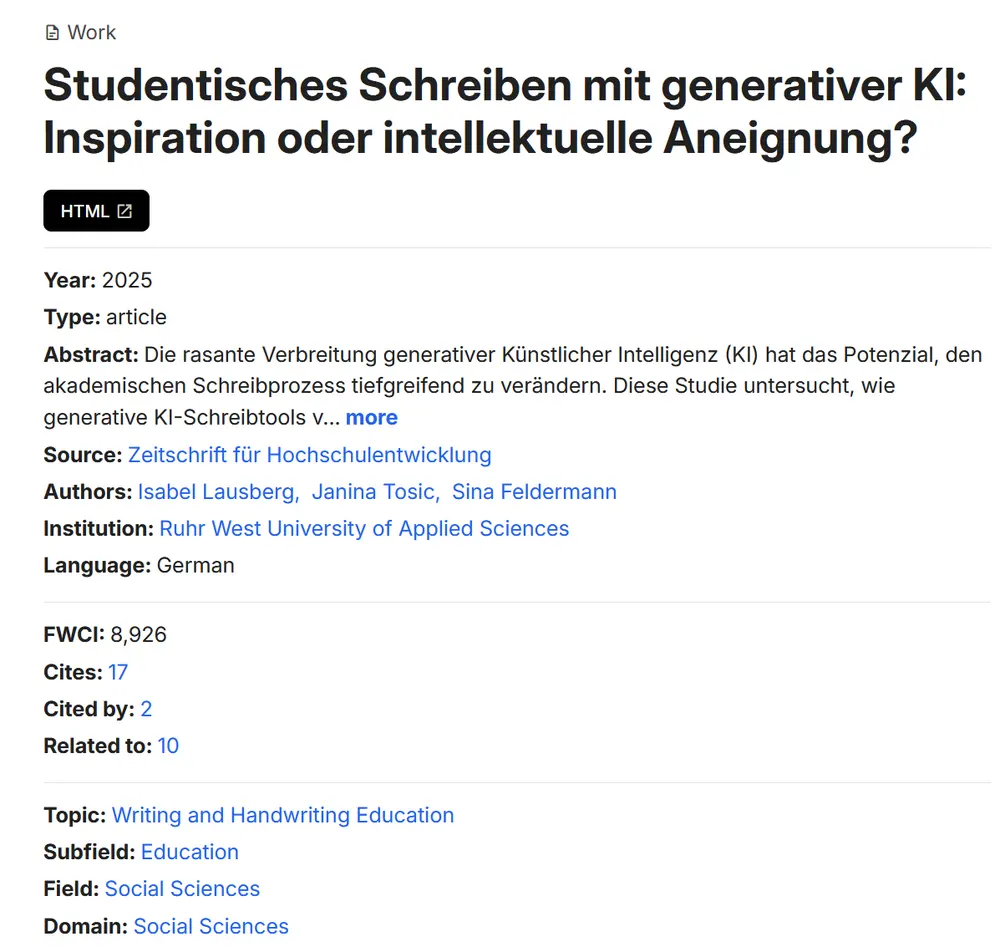
  • Related Articles suchen - diese müssen den Artikel weder zitieren noch von ihm zitiert werden
  • Bedeutung einer Studie im wissenschaftl. Feld durch Field-Weighted Citation Impact (FWCI) erkennen, hier: 28 Mal so häufig wie erwartet
Abbildung zu: Wie unterscheiden sich die Boolesche und die semantische Suche in OpenAlex?

Neu bei OpenAlex: der Novelty Score

  • OpenAlex hat eine semantische Suche integriert und prüft aktuell, ob es einen „Novelty Score“ als Indikator aufnimmt (OpenAlex)
  • Der Ansatz stammt von einem Team des Forschungszentrums Jülich, das im Juni 2026 die Metascience Novelty Indicators Challenge gewonnen hat
  • Die KI misst, was zum Zeitpunkt einer Publikation bekannt war, und bestimmt dann, was die Arbeit an Neuem beiträgt, z. B. eine neue Methode, ein überraschendes Ergebnis oder die Lösung eines offenen Problems
  • Ergebnis ist ein Neuigkeits-Score mit Unsicherheitsintervall und einer Begründung
  • Einordnung: KI verändert nicht nur die Recherche, sondern auch, wie Ergebnisse bewertet werden (Blogbeitrag dazu)
7alphaXiv und Wege zur Literatur

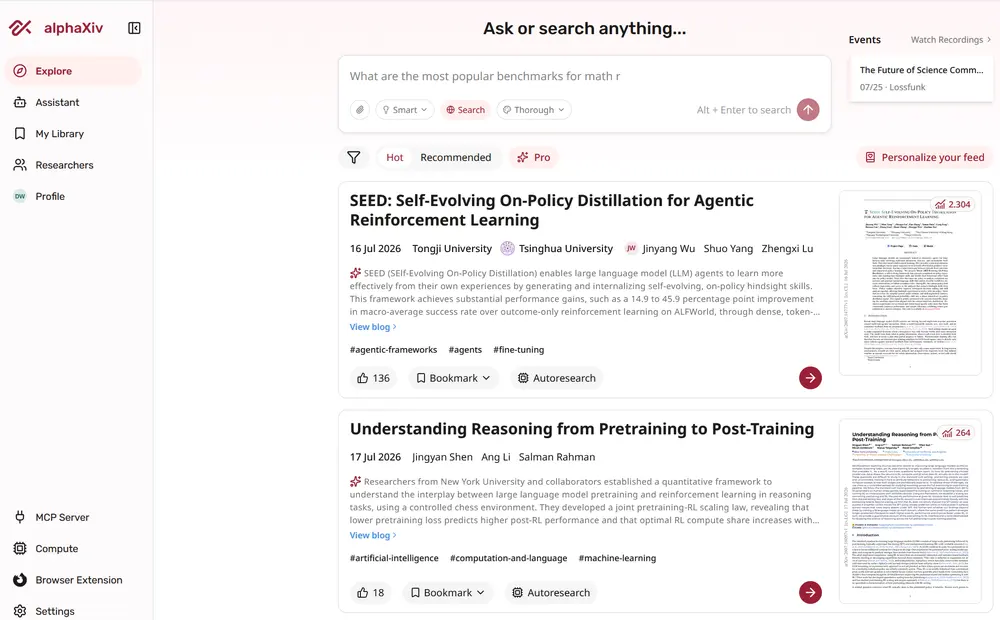
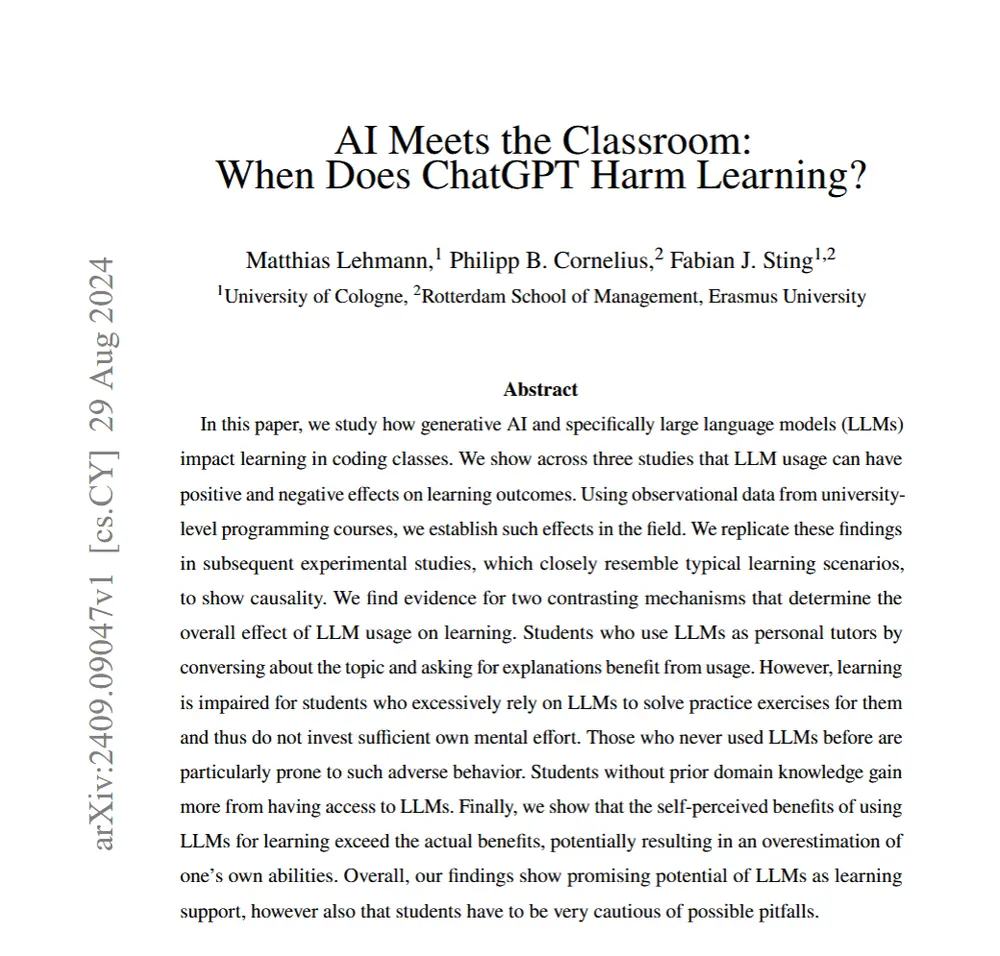
alphaXiv

Abbildung zu: alphaXiv (Link)

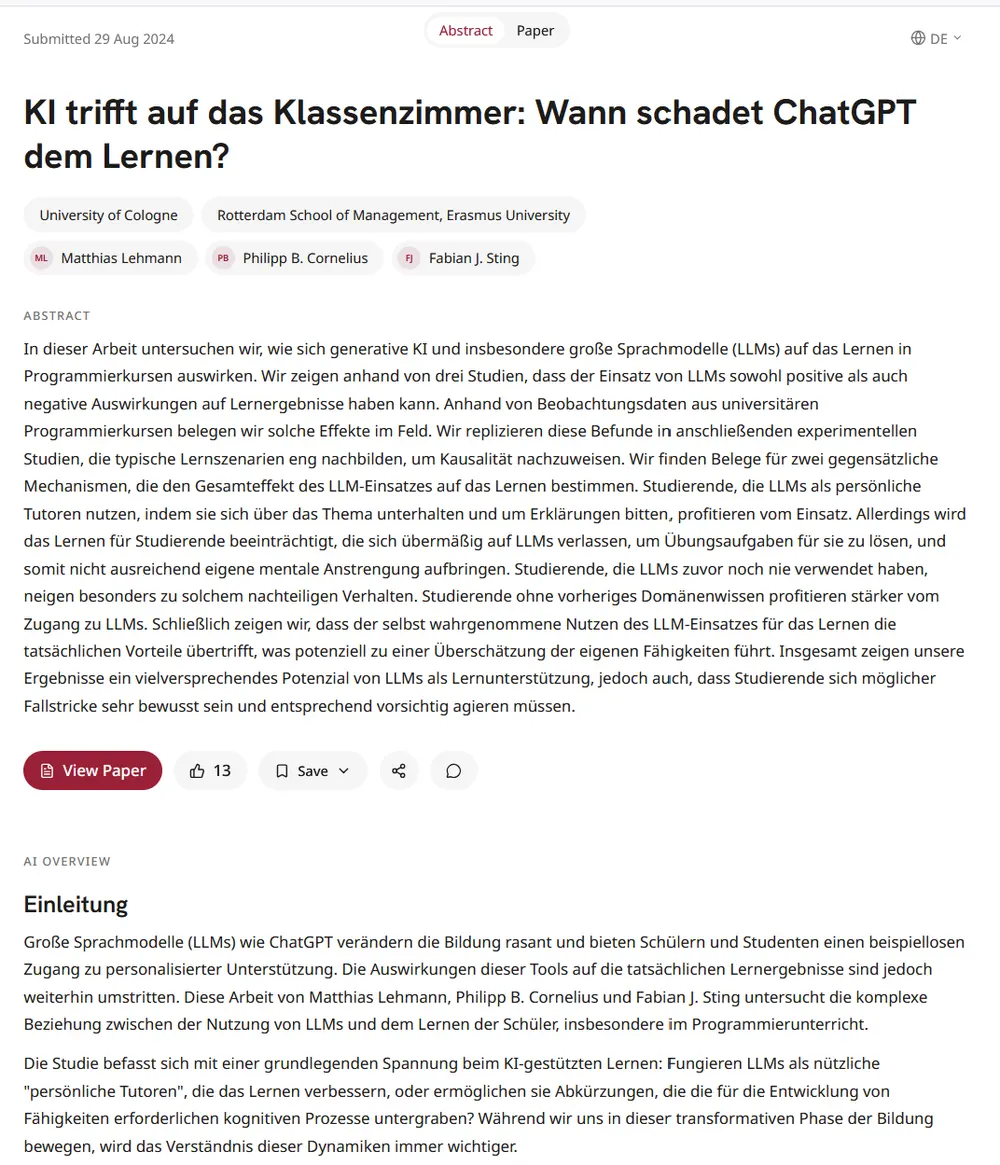
alphaXix: Prompteingabe

Abbildung zu: alphaXix: Prompteingabe

alphaXix: Quellen aus Ergebnissen können angeklickt werden

Abbildung zu: alphaXix: Quellen aus Ergebnissen können angeklickt werden

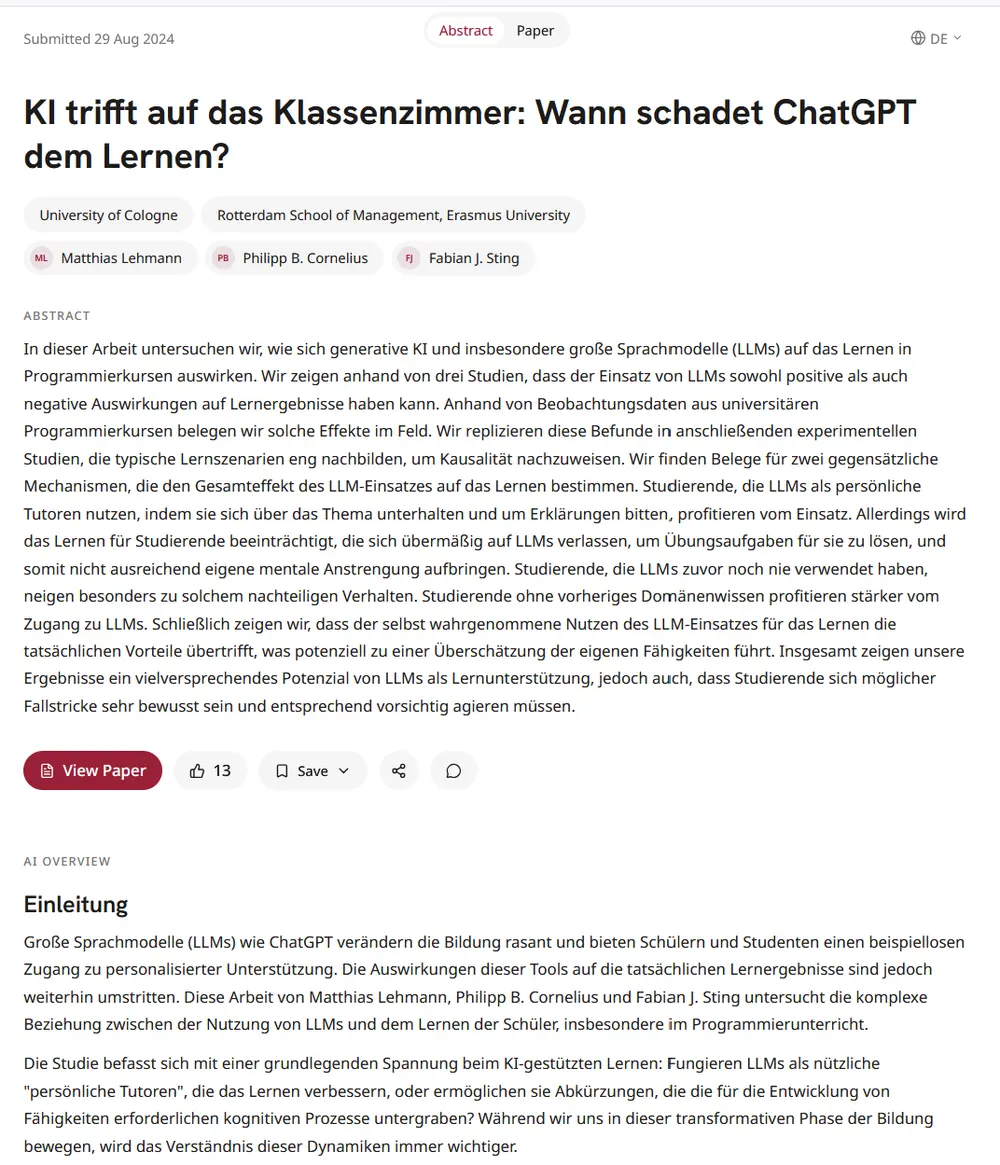
alphaXix: Quellen werden als wissenschaftlicher Blogbeitrags zusammengefasst, dann öffnen

Abbildung zu: alphaXix: Quellen werden als wissenschaftlicher Blogbeitrags zusammengefasst, dann öffnen

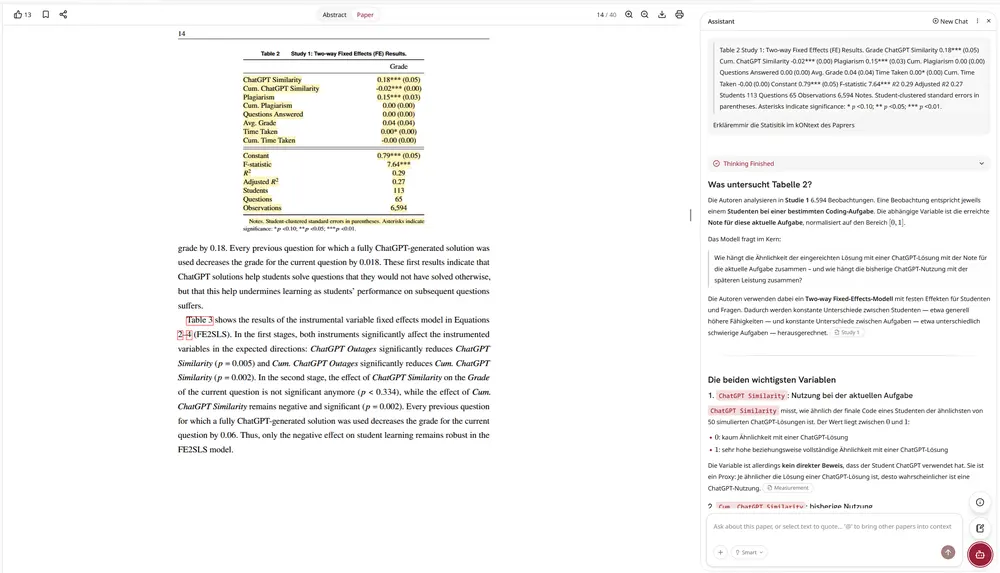
alphaXix: Textstellen, Abbildungen, Formeln usw. können durch KI-Agenten direkt befragt werden

Abbildung zu: alphaXix: Textstellen, Abbildungen, Formeln usw. können durch KI-Agenten direkt befragt werden

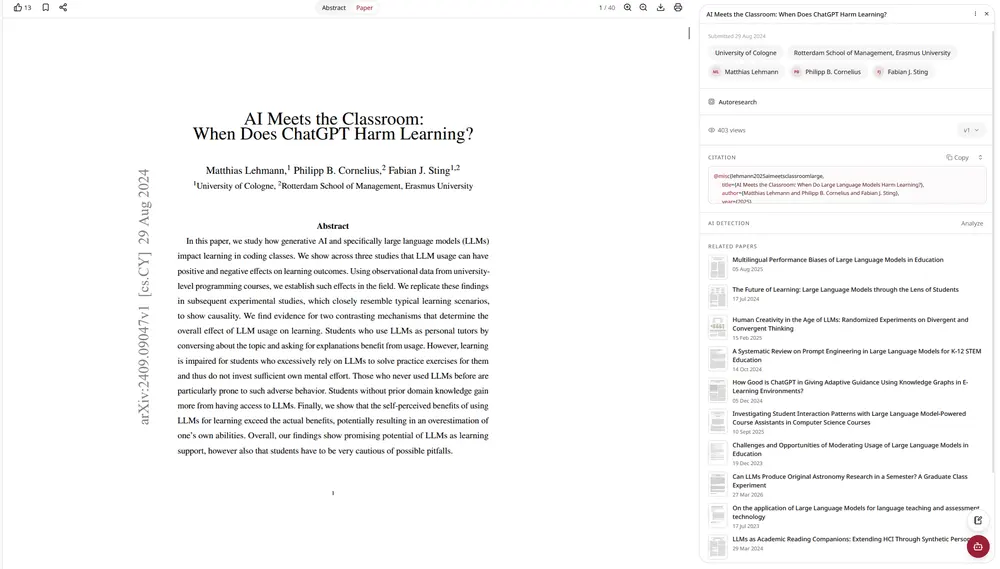
alphaXix: Das Infosymbol liefert verwandte Papers

Abbildung zu: alphaXix: Das Infosymbol liefert verwandte Papers

Wie funktioniert alphaXiv?

FunktionalitätErklärung
Overlay-LogikarXiv u.a. Datenlieferanten als Basis, alphaXiv legt KI darüber
RAG-Ansatz + agentische, mehrstufige Retrieval-ProzesseAgenten nutzen Keyword Suche, Vector Suche, Abstract- und Page-Reading-Tools, um mit arXiv-Korpus u.a. Datenquellen zu arbeiten und daraus über LLM die Antworten zu synthetisieren
KI-AssistenzNutzer können mit Papers interagieren
MetadatenTitel, Autoren, Datum, Kategorien
UploadEigene Dokumente können hochgeladen und mit Recherchen und KI-Analysen verbunden werden
Empfehlungslogikähnliche oder populäre Paper werden sichtbar gemacht

Welche Stärken hat alphaXiv?

StärkeRelevanz
sehr guter Zugriff auf arXiv-Paper u.a. Datenlieferantenstark im MINT-Bereich, andere Fächer uneinheitlich
niedrige EinstiegshürdePaper können erklärt, zusammengefasst, befragt und eigene Notizen hinzugefügt werden
arXiv Paper können in alphaXiv geöffnet und so alle KI-Funktionen genutzt werdenin URLs einfach „arxiv“ durch „alphaxiv“ ersetzen, z.B. https://arxiv.org/abs/2607.29610
https://alphaxiv.org/abs/2607.29610
Paper-Chat und ÜbersetzungenTextstellen, Methoden, Formeln und Abschnitte markieren und von KI erklären oder übersetzen lassen
Umwandlung von StudienPaper können in Blogbeiträge umgewandelt werden
Upload „externer“ PaperPaper können in Chat geladen und befragt werden

Welche Schwächen hat alphaXiv?

SchwächeErklärung
fachlicher Biasfachliche und thematische Abdeckung uneinheitlich
Preprint-“Problem“Paper sind (noch) nicht peer-reviewed, aber Preprints sind valider als ihre Reputation mitunter suggeriert (Link)
keine vollständige Forschungssuchebeschränkt auf arXiv bzw. angebundene Plattformen, nicht auf gesamte Wissenschaft (gilt für alle KI-Tools und Suchtplattformen)

Wie sahen die Wege zur wissenschaftlichen Literatur vor KI aus?

  • Keyword-Suche
  • Suche über Titel, Abstracts und Schlagwörter
  • Treffer hängen stark von den verwendeten Begriffen ab
  • Lineares Citation-Tracking
  • Ausgangspunkt ist ein relevantes Seed Paper
  • rückwärts: Welche Quellen zitiert das Paper?
  • vorwärts: Welche späteren Arbeiten zitieren das Paper?

Wie erweitert KI die Wege zur wissenschaftlichen Literatur?

  • Semantisch ähnliche Arbeiten
  • Systeme empfehlen inhaltlich ähnliche Paper auf Basis von Textmerkmalen
  • Netzwerkbasierte Verbindungen
  • Co-Citation = zwei Paper werden oft von denselben späteren Arbeiten gemeinsam zitiert
  • deutet darauf hin, dass sie thematisch zusammengehören, sodass sie von der KI auch ohne direkte Zitationsverbindung als ähnlich eingeordnet werden.
  • Inhaltliche Bewertung von Zitationen
  • KI kann den Kontext einer Zitation analysieren, z.B. zwischen unterstützenden, widersprechenden und lediglich erwähnenden Zitationsaussagen (siehe unten)
  • Paper können thematisch zusammengehören, auch ohne direkte Zitation: entweder weil sie häufig gemeinsam zitiert werden oder weil sie viele dieselben Quellen verwenden.

Wie erweitert KI die Wege zur wissenschaftlichen Literatur? Beispiel PubMed Linked Discoveries

  • Neue Funktion in PubMed: Linked Discoveries erstellt zu einem Artikel eine „Nachbarschaft“ inhaltlich ähnlicher Artikel und zeigt sie als Forschungsnetzwerk (Mitteilung der NLM)
  • Die Ähnlichkeit wird KI-gestützt anhand von Titeln, Abstracts und Keywords bestimmt, nicht allein durch Wortübereinstimmung wie bei „Similar articles“
  • Zitationsbeziehungen werden sichtbar, ebenso zurückgezogene Artikel (Retractions) und Reviews
  • Filter nach Krankheiten, Genen oder Substanzen sind möglich, jeder Artikel kann zum neuen Ausgangspunkt (Seed Paper) werden
  • Grenzen: Die Funktion ist ein experimentelles Pilotprojekt und noch nicht auf allen Artikelseiten verfügbar; Volltexte werden nicht ausgewertet
  • Mehr dazu im Blogbeitrag
8KI-Tools im Überblick

Auswahl wissenschaftsspezifischer KI-Tools für die Daten- und Literaturrecherche (Zugang durch Klick auf die jeweiligen Grafiken)

Abbildung zu: Auswahl wissenschaftsspezifischer KI-Tools für die Daten- und Literaturrecherche (Zugang durch Klick auf die jeweiligen Grafiken)

Tools in dieser Übersicht:
Was muss bei der wissenschaftlichen Recherche mit KI-Tools generell beachtet werden?

  • Kein Tool ist vollständig: jedes System hat blinde Flecken bei Fächern, Sprachen, Dokumenttypen, Volltextzugang usw.
  • Mehr Treffer sind nicht automatisch besser: viele Treffer können bedeuten: mehr Rauschen, mehr Dubletten, mehr Screening-Aufwand, mehr irrelevante Nachbarliteratur.
  • Gute Ergebnisse hängen von drei Ebenen ab: Fragequalität, Datenbasis und Systemlogik. Ein guter Prompt kann eine schwache Datenbasis nicht kompensieren.
  • Sichtbarkeit ist nicht gleich Qualität: Ein Paper kann fachlich top sein und trotzdem nicht erscheinen, z.B. weil Metadaten schlecht sind oder der verwendete Begriff nicht passt
  • Die Aufgabe des Wissenschaftlers verschiebt sich bei der Recherche: Nicht nur suchen, sondern KI-Systeme auswählen, Datenbasis verstehen, Ergebnisse vergleichen, Quellen prüfen, Lücken erkennen, Evidenzen bewerten.
  • Eine KI-gestützte Recherche ist ein Zusammenspiel aus Forschungsfrage, Datenbasis, der Methode, mit der das System aus dem Datenbestand Dokumente auswählt und ordnet (Retrieval), dem Ranking, dem zugrunde liegenden Modell und der menschlichen Prüfung.
  • Es gibt eine sehr große Auswahl an KI-Tools – am besten ausprobieren!
  • Für den Einstieg genügt ein kostenloser Account.
  • Die Tools greifen teilweise auf unterschiedliche Datengrundlagen zurück, beispielsweise Semantic Scholar oder OpenAlex.
  • Bei Fragen können Sie sich gerne an mich wenden.
9scienceOS

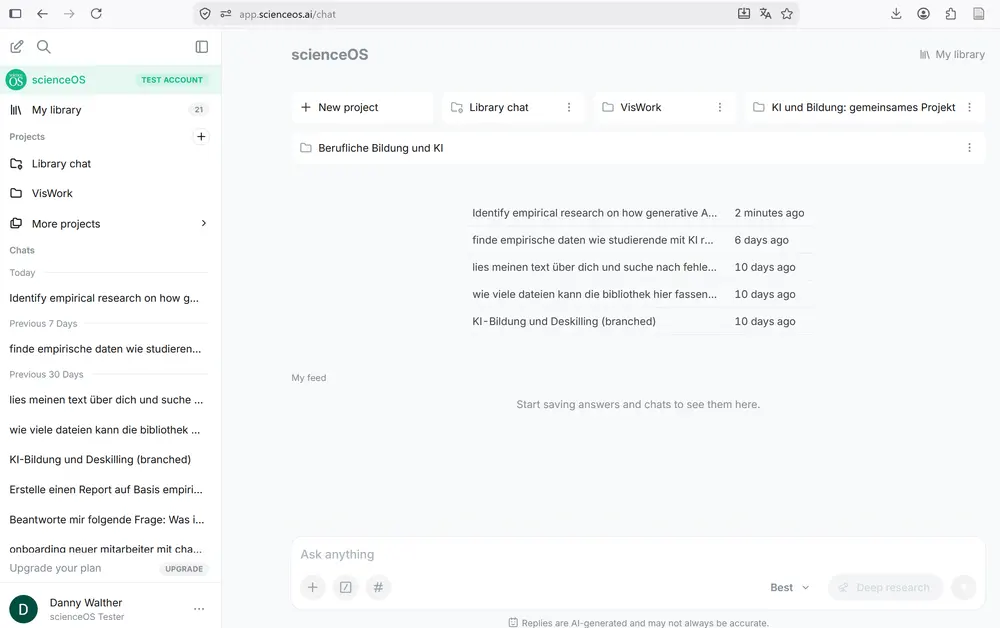
scienceOS

Abbildung zu: scienceOS (Link)

Was ist scienceOS?

  • KI-gestützte Plattform für wissenschaftlichen Suche und Analyse
  • Basis: Semantic-Scholar-Datenbank mit mehr als 237 Mio. Papern → Semantic Scholar liefert den Forschungskorpus, scienceOS liefert die Such-, Interaktions- und Analyseebene
  • scienceOS unterstützt Literatursuche, Paper-Chat, Visualisierung, Vergleich und Synthese
  • verfügt über einen selbsterklärenden Chatbot, der alle Fragen zum Programm beantwortet
  • Aufbau persönlicher Bibliotheken und gemeinsamer Projekte möglich
  • persönliche Bibliothek kann bis zu 4.000 Dokumente enthalten
  • scienceOS wird in Dresden entwickelt, in Europa gehostet und ist 100% DSGVO-konform
  • dennoch sollten keine personenbezogenen oder sensiblen Daten hochgeladen werden  für sensible Daten lokale Systeme wie Ollama (Link) nutzen

Wie funktioniert die explorative Recherche und wie selektiert scienceOS Literatur?

  • Schritt 1: Breite Recherche
  • Nutzer stellt eine Forschungsfrage in natürlicher Sprache
  • scienceOS durchsucht den Semantic-Scholar-Korpus
  • Hunderte potenziell relevanter Quellen werden identifiziert
  • Schritt 2: Auswahl und Ranking
  • Dutzende Quellen werden für die genauere Analyse ausgewählt, basierend auf:
  • semantischer Relevanz / Publikationsdatum / Zitationswirkung / Bedeutung als grundlegende Studie / Qualität des Publikationsorgans
  • Schritt 3: Synthese
  • relevante Informationen werden extrahiert, System generiert quellenverknüpfte Antwort
  • Quellen und – wenn möglich – Seitenangaben werden für Antwort genutzt

Wie funktioniert ScienceOS im Detail?

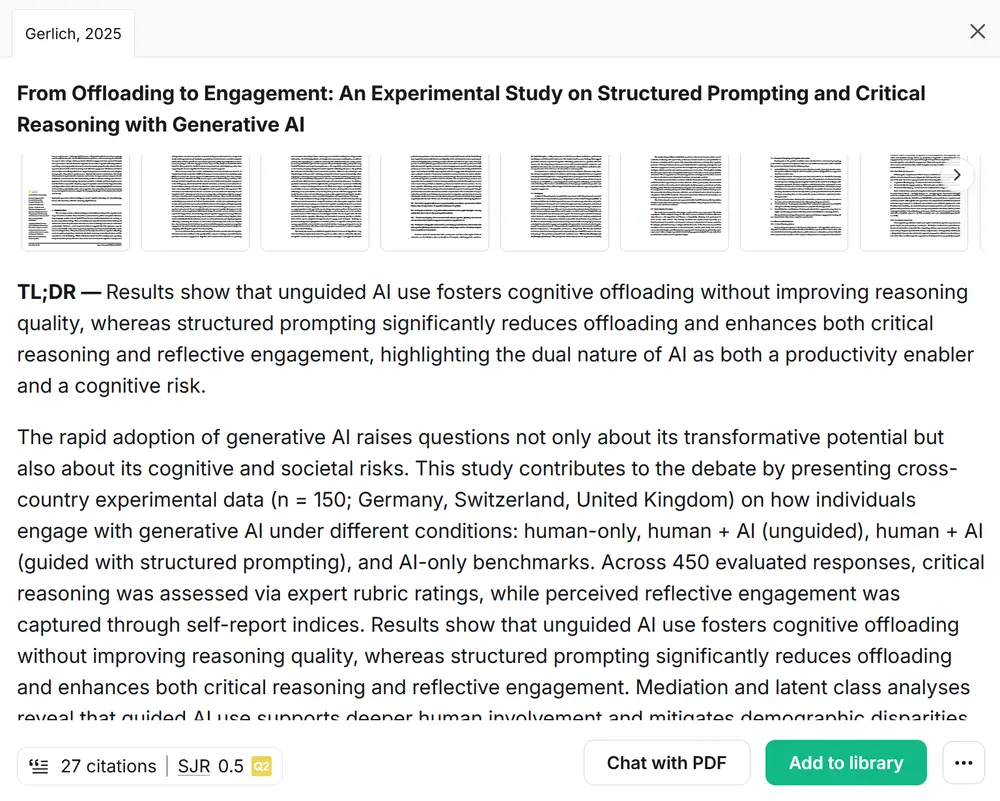
  • Die folgenden Folien zeigen Analyse-Möglichkeiten von scienceOS am Beispiel der Studie von Gerlich (2025). From Offloading to Engagement: An Experimental Study on Structured Prompting and Critical Reasoning with Generative AI. Data, 10, 172. https://doi.org/10.3390/data10110172
  • Falls scienceOS von einer Studie nur den Abstract, nicht den Volltext hat, Google Scholar nutzen, Paper suchen und ggf.

Welche Informationen und Funktionen bietet das?

  • bibliografische Angaben
  • eine knappe TL;DR-Zusammenfassung
  • das Abstract
  • Zitationsdaten, hier: 27 Zitate (vgl. Google Scholar = 35, Link) → Zitationszahlen unterscheiden sich zwischen Plattformen, da Datenbanken unterschiedliche Abdeckungs- und Indexierungsmethoden verwenden
  • Zitationswirkung und Journal-Indikator, hier: Q2
  • Option, das Paper zur Bibliothek hinzuzufügen
  • Wenn PDF vorhanden oder zugänglich ist
  • detaillierte Fragen zum Paper stellen
  • Inhalt, Methoden, Befunde, Grenzen prüfen
  • Belege anfordern, die mit Seiten verknüpft sind
  • Wenn kein PDF vorhanden oder zugänglich ist, werden Abstract und Metadaten ausgewertet
Abbildung zu: Welche Informationen und Funktionen bietet das?

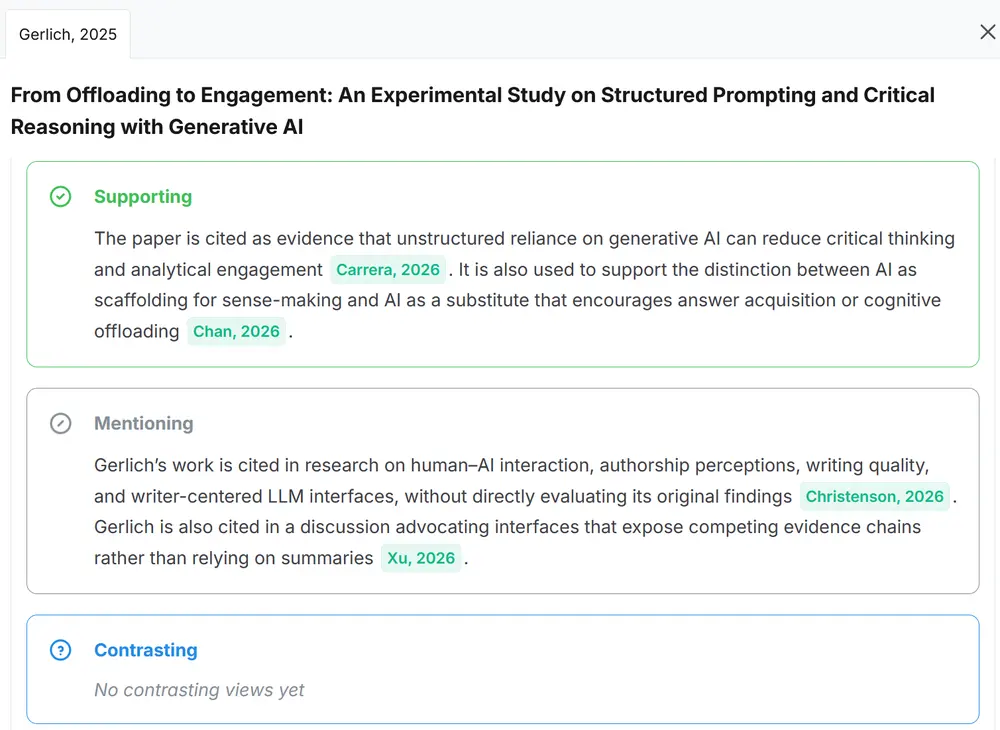
„How this paper is cited“ enthält eine qualitative Einschätzung, wie eine Studie rezipiert wurde

  • Unterstützend (supporting): Zitate, die die Arbeit bestätigen oder darauf aufbauen
  • Erwähnend (mentioning): Arbeit nur als Referenz angeführt, ohne sie näher zu analysieren, oft aber zustimmend
  • Widersprechend (contrasting): Zitate, die die Ergebnisse in Frage stellen / widerlegen
  • Wie entsteht diese Zuordnung?
  • Zuordnung basiert auf semantischer Analyse von Sprache, Formulierung + Zitationskontext
  • für die Analyse werden die Zitationskontexte der Publikation in scienceOS untersucht
  • Warum ist das nützlich?
  • Geht über quantitative Zitationszahlen hinaus
  • Inhaltlich ähnlich sind Tools wie Scite.ai (Link), Consensus u.a.
Abbildung zu: „How this paper is cited“ enthält eine qualitative Einschätzung, wie eine Studie rezipiert wurde

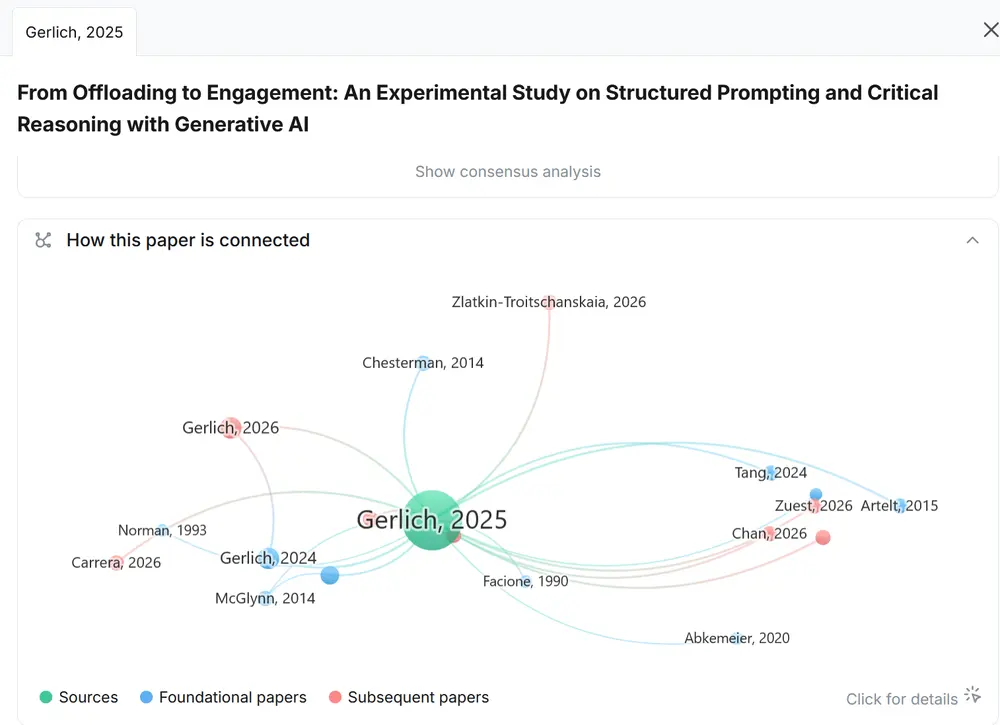
„How this paper is connected“ enthält:

  • Gerlich (2025) ist der zentrale Knotenpunkt (sog. „Seed Paper“)
  • blaue Verbindungen = Grundlagenstudien, auf denen Ghodsi et al. Ihr Paper aufgebaut haben (= backward citation tracking)
  • ist aber nur Auswahl der Studien, die mit dem Paper in Verbindung stehen
  • rot markierte = Paper, die ihre Studien auf Gerlich (2025) aufgebaut haben (= forward citation tracking
  • alle Linien markieren lineare Verbindungen, keine semantischen Ähnlichkeiten ohne direkte Zitations-Verkettung
  • die Linien zeigen nur, dass eine Verbindung existiert, nicht warum, mehr dazu bei Tools wie Connected Papers (Link) u.a.
  • Die Position der Paper im Zitationsnetzwerk wird durch einen Algorithmus bestimmt, der primär ein übersichtliches Layout zum Ziel hat.
  • Distanz zwischen Papern ist kein Maß für inhaltliche Ähnlichkeit. Sie wurden ausgewählt, weil sie generell ähnlich sind.
Abbildung zu: „How this paper is connected“ enthält:

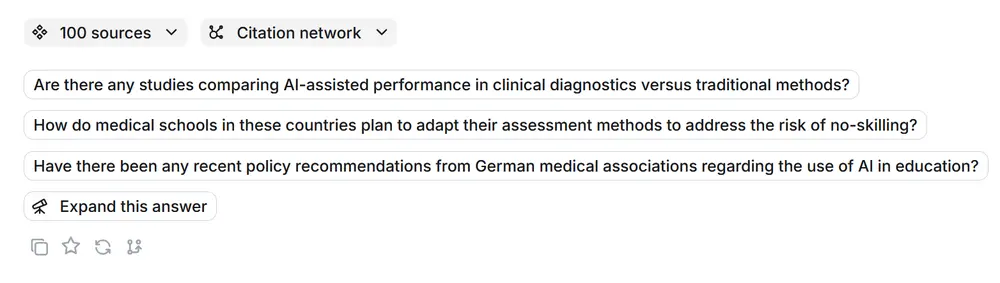
Wie kann der Nutzer mit KI-Antworten bei scienceOS weiter verfahren?

  • alle durchsuchten Quellen (bis zu 100) einsehen
  • Zitationsnetzwerk daraus erstellen
  • Follow-up Fragen stellen
  • Paper hochladen und mit Chatverlauf kontextualisieren
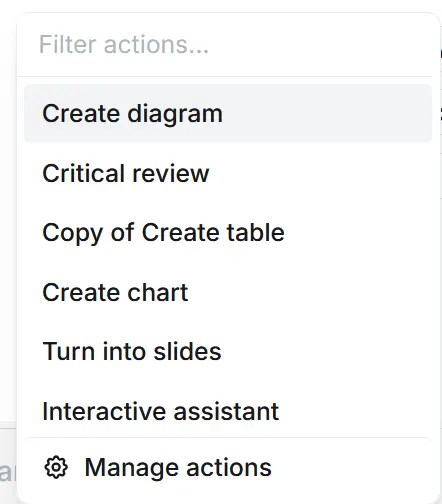
  • sciencOS schlägt weitere Schritte und Aktionen vor, etwa:
  • Diagramme oder andere visuelle Ausgaben erzeugen
  • Tabelle mit Ergebnissen generieren
  • Visualisierungen erstellen usw.
Abbildung zu: Wie kann der Nutzer mit KI-Antworten bei scienceOS weiter verfahren?

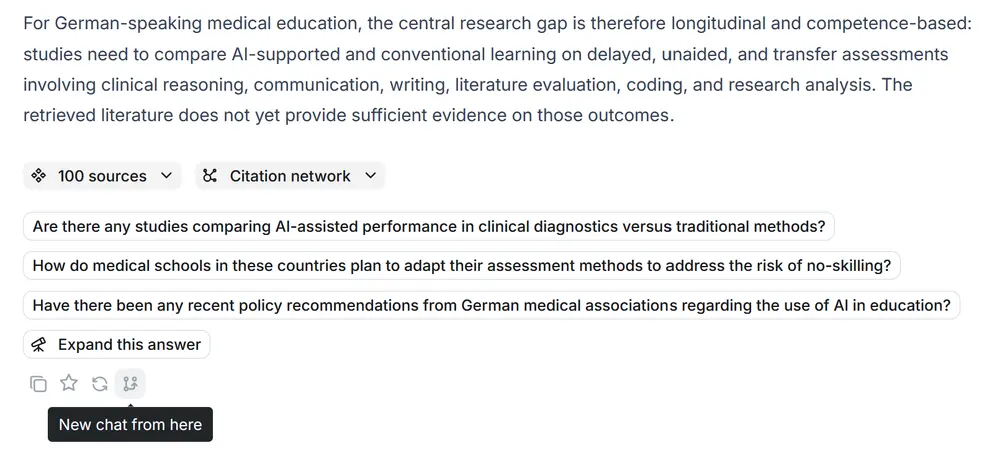
Wie können Nutzer eine sciencOS-Analyse fortführen, abbrechen und verzweigen?

  • durch “New chat from here” kann eine Unterhaltung an jeder beliebigen Stelle abgebrochen und neu gestartet werden
  • lohnt sich besonders dann, wenn man eine andere Forschungsrichtung erkunden will oder eine Suchanfrage neu formulieren möchte
Abbildung zu: Wie können Nutzer eine sciencOS-Analyse fortführen, abbrechen und verzweigen?

Was bietet scienceOS noch?

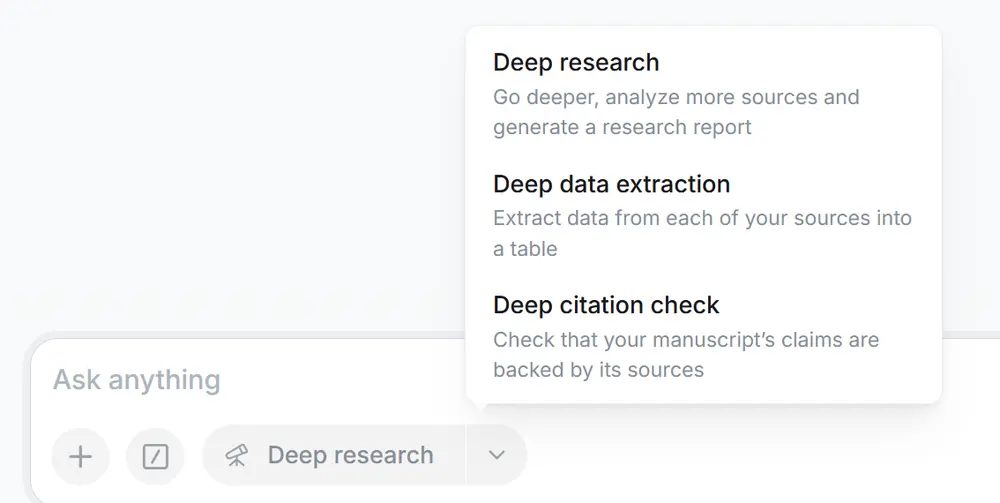
  • Deep Data Extraction:
  • konzentriert sich auf die standardisierte Informationsgewinnung
  • statt einen Fließtext zu erstellen, werden aus den Quellen gezielt vergleichbare Angaben herausgearbeitet
  • z.B. Studiendesign, Stichprobengröße, Intervention, Messmethode, Hauptergebnis oder Limitationen
Abbildung zu: Was bietet scienceOS noch?
  • Deep Citation Check: dient der Quellen- und Zitierkontextprüfung
  • Anleitung (Link)
  • Alle im Manuskript zitierten Quellen in die scienceOS-Bibliothek hochladen.
  • Ein neues Projekt erstellen und die Quellen dem Projekt hinzufügen.
  • zu prüfendes Manuskript in einen Projekt-Chat hochladen.
  • In „Deep Research“ jede Aussage mit der jeweils zitierten Quelle abgleichen lassen.
Abbildung zu: Was bietet scienceOS noch?

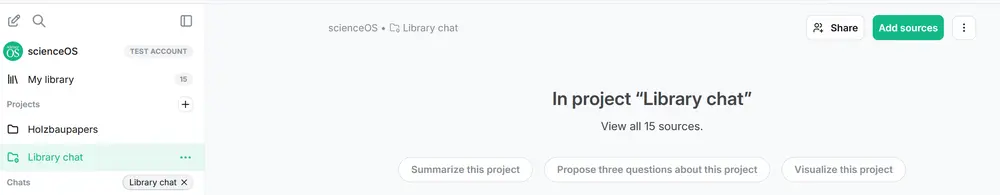
Welche Vorteile bietet eine Bibliothek in scienceOS?

  • Bis zu 4.000 Quellen per PDF-Upload, Zotero, DOI, RIS oder BibTeX
  • Collections zur thematischen und projektbezogenen Organisation
  • Einzelne oder mehrere Paper gezielt befragen
  • Vergleich und Analyse von bis zu 8 PDFs gleichzeitig
  • Analyse wahlweise mit eigenen Quellen oder zusätzlich mit Semantic-Scholar-Datenbank
  • Quellen in Projekten mit Kolleginnen und Kollegen teilen
  • Erweiterte PDF-Erkennung für Text, Scans, Tabellen und Abbildungen
Abbildung zu: Welche Vorteile bietet eine Bibliothek in scienceOS?

Aktuell arbeitet scienceOS an einer Funktion zur Datenanalyse, um csv-Dateien statistisch auswerten &amp; visualisieren zu lassen. Die Funktion wird noch in 2026 verfügbar seinAktuell gibt es schon eine Reihe von Tools, die Datenanalysen durchführen können, u.a.:- julius: eines der stärksten Tools (<a href="https://julius.ai/" target="_blank" rel="noopener noreferrer">Link</a>)- Asta (free, <a href="https://asta.allen.ai/" target="_blank" rel="noopener noreferrer">Link</a>): Recherche-Tools mit Datenanalyse-Funktion- Datenanalyse-Agent der „europäischen“ KI Mistral

  • Was wird scienceOS in Zukunft noch beinhalten?
10Asta, Perplexity, Consensus und Scite

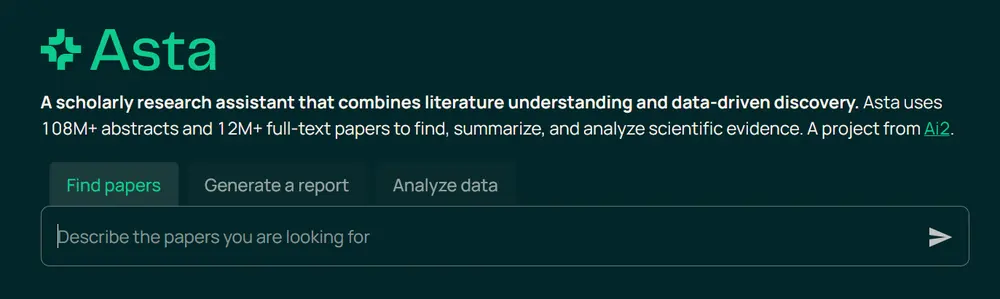
Wie funktioniert AI2 und was findet man da?

  • komplett kostenloses KI-Tool
  • drei Hauptfunktionen:
  • „Find papers“ = einfache Literatursuche
  • „Generate a report“ = erstellt KI-generierte Zusammenfassung als Antwort auf Suchanfrage
  • „Analyze Data“ = erzeugt KI-generierte Analyse eines Datensatzes
Abbildung zu: Wie funktioniert AI2 und was findet man da? (Link)

Quelle der Abbildung: asta.allen.ai

Wie funktioniert Asta?

SchrittWas passiert?
1. AnfrageNutzer stellt eine (komplexe) Forschungsfrage in natürlicher Sprache
2. ZerlegungSystem interpretiert Intention, Kriterien und Teilaspekte
3. RetrievalKandidaten-Paper werden aus dem wissenschaftl. Korpus gesucht
4. RerankingTreffer werden nach Relevanz für die konkrete Frage neu gewichtet
5. EvidenzextraktionPassagen / Belege werden aus Daten der Studien herangezogen
6. SyntheseLLM erzeugt Antwort, Trefferliste oder Bericht
7. QuellenbindungAussagen werden mit Inline-Zitationen + Evidence Cards verknüpft

Welche Stärken hat Asta?

StärkeRelevanz
Tiefe Retrieval-PipelineAsta kombiniert Retrieval, Re-Ranking, Zitationslogik und Evidenzextraktion.
Abstract + Volltext-KorpusIm Unterschied zu vielen Tools arbeitet Asta nicht nur mit Abstracts, sondern auch mit einem großen Volltextindex von ca. 12 Mio Papers
Evidence CardsZitationen sind nicht nur Literaturangaben; Nutzer können über „Show Evidence“ unterstützende Evidenzpassagen aufrufen.
Paper Finder erklärt RelevanzEs zeigt nicht nur Treffer, sondern begründet, warum ein Paper zur Frage passt. Das ist bei schwierigen oder interdisziplinären Themen stark.
ScholarQA erzeugt strukturierte ReportsAntworten sind in Abschnitte mit TL;DR und Inline-Zitationen gegliedert, damit besser überprüfbar als freie Chat-Antworten
FächerbreiteAsta deckt alle Fächer ab, wenn auch – wie alle KI-Systeme – ungleichmäßig (siehe Folie zu den Biases oben)

Welche Schwächen hat Asta? (Gilt für fast alle KI-Tools)

SchwächeErklärung
Passage-Level-Retrieval fragmentiert PapersEvidenz wird aus einzelnen Snippets statt aus vollständigen Argumentationszusammenhängen extrahiert
Auswahl max. 256 PassagenKI arbeitet mit stark vorselektierter Evidenzmeng
es bleibt ggf. viel Literatur unberücksichtigt
Neural Re-ranking erzeugt verdeckte EvidenzhierarchienModell entscheidet aktiv, welche Passagen als „wichtiger“ gelten
semantic similarity bevorzugt sprachlich ähnliche Papersmethodisch relevante, aber anders formulierte Arbeiten fehlen evtl.
SchwächeErklärung
Citation Traversal verstärkt existierende Sichtbarkeithäufig zitierte Forschungsrichtungen werden bevorzugt
Evidence Cards zeigen nur extrahierte EvidenzsegmenteNutzer sehen oft nicht vollständigen methodischen / argumentativen Kontext
Volltext-Retrieval abhängig von parsebaren DokumentenInformationsverlust durch schlecht strukturierte PDFs oder komplexe Layouts
starke InfrastrukturabhängigkeitRetrievalqualität abhängig von:
Embeddings
Parsing (Maschinenlesbarkeit)
Chunking (Aufteilung des Papers in Abschnitte
internen Retrieval-Agenten (Suchstrategien, Re-Ranking usw.)

Perplexity

Abbildung zu: Perplexity (Link)

Wie unterstützt Perplexity die Recherche?

  • Perplexity vermarktet sich selbst als KI-gestützte Antwortmaschine, Recherche-Plattform und Wissens-Engine und ist (daher) im akademischen Bereich relativ bekannt
  • Perplexity kombiniert Live-Websuche mit KI-generierten Antworten
  • Fragen können in natürlicher Sprache gestellt werden
  • Antworten enthalten Inline-Zitate und direkte Links zu Quellen
  • Follow-up-Fragen ermöglichen iteratives Weiterrecherchieren
  • Ergebnisse können wissenschaftliche Publikationen, offizielle Dokumente, Berichte und allgemeine Websites umfassen
  • der gewählte Suchmodus, Workspace-Anweisungen und verfügbare Quellen beeinflussen, was sichtbar wird.
  • Perplexity ist nützlich für eine schnelle Orientierung, muss aber für eine umfassende wissenschaftliche Suche „feinjustiert“ werden

Welche Perplexity-Funktionen sind für wissenschaftliche Recherchen am nützlichsten?

FunktionPrimärer ZweckGeeignet für
Searchschnelle, quellenverknüpfte RechercheEinsteiger
Deep Researchbreitere, mehrstufige Untersuchungfortgeschrittene Nutzer
Spaces / Projectsdauerhafte Anweisungen, Prompts, Dateien, Skills und Projektkontextwiederkehrende Recherche
Computer + Skillskomplexe, wiederverwendbare WorkflowsPower-User
  • Beginne mit Search, vertiefe mit Deep Research, organisiere und recherchiere dann mit Spaces, und nutze Computer + Skills als mögliche zusätzliche Option für Fortgeschrittene.
  • Space-Anweisungen definieren die dauerhafte Recherche-Perspektive. Der einzelne Prompt definiert die konkrete Frage. Ein Skill definiert eine wiederverwendbare Methode.

Warum liefert derselbe Prompt in Perplexity unterschiedliche Ergebnisse?

EinstellungPrimäre SuchgrundlageTypisches Ergebnis und Quellen
SearchSuche im offenen Webschnelle Antworten aus wissenschaftlichen, offiziellen, kommerziellen u.a. Web-Quellen
Deep Researchmehrstufige Untersuchung über mehrere Quellen, inkl. Vergleich & Syntheselängere, strukturiertere Berichte basierend auf einem breiteren Such- und Analyseprozess
Personalised SpaceSuche mit dauerhaften Anweisungen, hochgelad. Dateien, ausgewählten Quellen und ProjektkontextErgebnisse geprägt durch gespeicherte Rechercheregeln, Materialien und vorherigen Kontext
  • Search bestimmt den unmittelbaren Quellenmix, Deep Research verändert Tiefe und Ablauf der Suche, und ein Space fügt dauerhafte Anweisungen und projektspezifischen Kontext dazu.

consensus

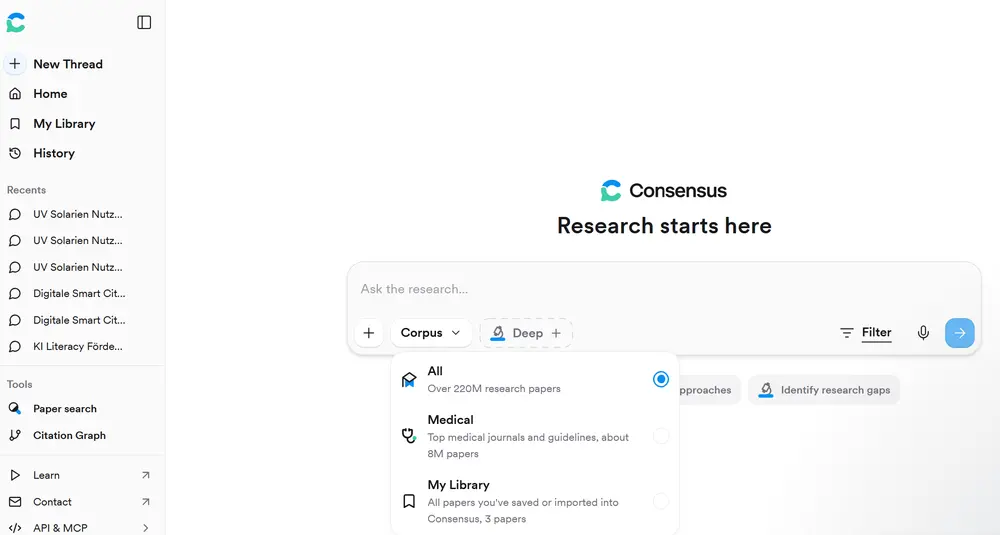
Abbildung zu: consensus (Link)

Was ist Consensus?

  • KI-gestützte Suchmaschine für die Recherche und Synthese wissenschaftlicher Literatur.
  • Consensus unterstützt die Literatursuche mittels natürlicher Sprache, das Extrahieren von Kernergebnissen (Key Takeaways) sowie automatisierte Literaturübersichten.
  • Basis: Greift auf Datenbank von 237 Millionen wissenschaftlichen Arbeiten zu – aggregiert primär aus Semantic Scholar, OpenAlex sowie eigenen Verlagskooperationen.
  • Verfügt über „Consensus Meter“: analysiert bei Ja/Nein-Fragen die Ergebnisse und zeigt, wie viele Studien der Behauptung zustimmen, widersprechen bzw. unentschieden sind
  • „Deep Search“-Funktion: Ermöglicht eine KI-gestützte, tiefergehende Analyse, die strukturierte Berichte inklusive Forschungslücken und Gegenargumenten erstellt.
  • „Medical Mode“: Verfügt über einen speziellen Filter für klinische Evidenz, der gezielt ein kuratiertes Subset aus rund 8 Millionen Fachartikeln und über 50.000 klinischen Leitlinien der weltweit führenden medizinischen Fachzeitschriften durchsucht.

scite

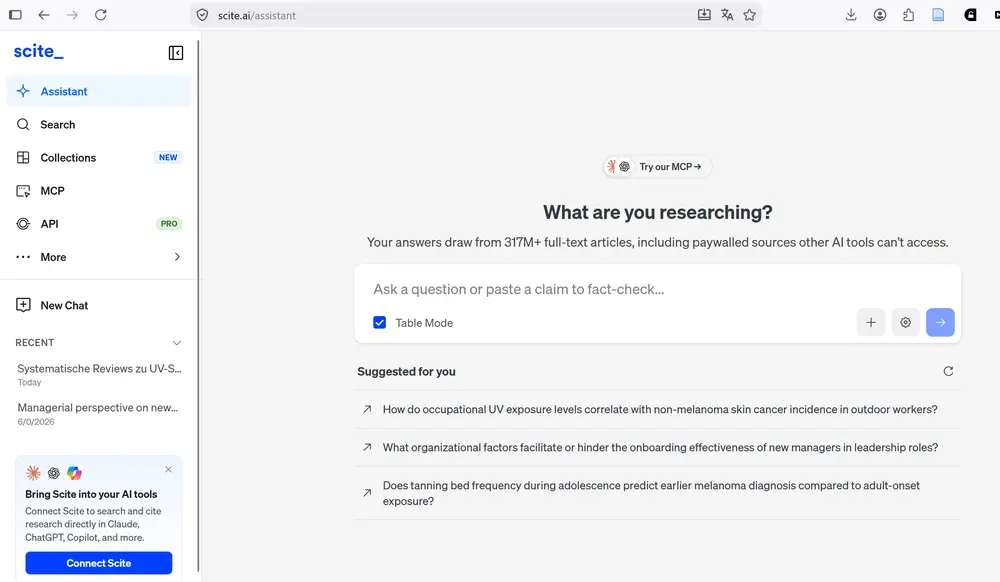
Abbildung zu: scite (Link)

Was ist Scite?

  • KI-gestützte Such- und Analyseplattform für die Recherche wissenschaftlicher Literatur mit Fokus auf die Validität und Rezeption von Forschungsergebnissen
  • Greift auf eine Datenbank von über 300 Mio. wissenschaftlichen Volltexten sowie über 200 Mio. Patenten zu – indiziert Zitate direkt aus dem Volltext durch Verlagskooperationen
  • Smart Citations: analysiert Zitationssätze im Kontext und kategorisiert sie automatisch in Supporting (Unterstützend), Contrasting (Widersprechend) oder Mentioning (Erwähnend).
  • „scite Assistant“: Ermöglicht KI-gestützte Beantwortung von Fragen in natürlicher Sprache, wobei jede Aussage mit Quellen belegt wird, um Halluzinationen zu vermeiden.
  • „Reference Check“: Ermöglicht den Upload eigener Manuskripte oder PDFs, um die verwendete Literatur automatisch auf zurückgezogene Studien (Retractions) oder starke wissenschaftliche Kontroversen zu prüfen
  • Collections: Papers in Bibliothek(en) speichern und gezielt befragen und vergleichen
  • Link zum Testergebnis
11Von der Recherche zum Text

Was macht man mit den verschiedenen Ergebnissen (KI-Tool-Antworten) nach der Recherche?

  • Ein Fachartikel besteht aus zwei unterschiedlichen Textarten
  • Diese Aufteilung bestimmt, was KI „darf“
  • 1.) Literaturbasierte Teile (Hintergrund / Einleitung, Teile der Diskussion):
  • KI darf hier strukturieren und formulieren, jedoch nur auf Basis geprüfter, mit Quellen belegter Aussagen.
  • 2.) Datenbasierte Teile (Methoden, Ergebnisse, eigene Befunde):
  • KI erzeugt hier keine Inhalte, sondern formuliert, übersetzt oder formatiert nur.
  • Die Zahlen, Methodik und Interpretation der eigenen Daten bleiben in Ihrer Hand.
  • Alles Folgende betrifft nur den 1. Bereich und den Übergang, an dem beide Bereiche in der Diskussion zusammentreffen (Schritt 4).
  • Kurzfassung
  • 1. Vergleichen: Tool-Antworten abgleichen, Kernkorpus von Ausreißern trennen.
  • 2. Bereinigen: nur belegte Aussagen in eine gemeinsame Ausgangsbasis überführen.
  • 3. Teile mit KI schreiben: z.B. Einleitung
  • 4. Prüfen und Schreiben: Quellen checke und Entwurf mit eigener Stimme versehen
  • 5. Offenlegen: KI-Einsatz transparent machen.

1. Variante A: Die Volltexte der Papers vergleichen

  • Alle in Antworten genannten Paper beschaffen, Vergleich erfolgt auf Basis der Originaltexte.
  • Vorteile
  • Einzige Möglichkeit zu verifizieren, ob eine Tool-Zusammenfassung akkurat war
  • Deckt Fehler auf, die sich durch alle Tools ziehen
  • Ohnehin nötig: zitiert wird am Ende die Originalstudie, nicht die KI-Zusammenfassung
  • Nachteile
  • Zeitaufwand, bei 20 - 30 Papers wird daraus ein eigenes kleines Review
  • Paywall-Problem bleibt bestehen
  • Urheberrechtlich heikel: ganze PDFs unbedacht in Cloud-KI-Tools hochladen
  • Verschiebt das Risiko von „Halluzinationen“ auf Ebene des Volltext-Extrahierens

1. Variante B: Zusammenfassungen der KI-Tools vergleichen

  • Die KI-Zusammenfassungen miteinander vergleichen, ohne Rückgriff auf die Originalstudien.
  • Vorteile
  • Schnell, auch ohne Volltextzugang möglich (funktioniert trotz Paywalls)
  • Reicht für die Synthese-Ebene, die Sie für Einleitung/Diskussion brauchen
  • Guter erster Filter: Kernkorpus (von mehreren Tools bestätigt) von Ausreißern trennen
  • Nachteile
  • Prüft nur, ob sich die Tools einig sind, nicht, ob sie richtig liegen
  • Ein Fehler kann sich durch mehrere Tools ziehen, ohne aufzufallen
  • Bei Widerspruch zwischen zwei Tool-Ergebnissen bleibt offen, welche Version stimmt
  • Nuancen gehen verloren: Subgruppen, Limitationen usw werden beim Zusammenfassen oft weggelassen oder geglättet

1. Variante C: Der Mittelweg: Prüftiefe nach Gewicht der Aussage

  • Ergebnisse der KI-Zusammenfassungen hochladen, dann Prompt:
  • „Ich habe mehrere KI-Recherche-Ergebnisse zum selben Thema hochgeladen. Gehe so vor:
  • Vergleiche die Ergebnisse: Welche Studien bzw. Aussagen nennen alle oder fast alle Quellen übereinstimmend? Welche nennt nur eine einzige Quelle?
  • Erfinde nichts, was nicht in den Dateien steht. Schreibe „nicht angegeben", wenn eine Angabe fehlt. Bilde keine Mittelwerte aus unterschiedlichen Zahlen verschiedener Tools, sondern nenne beide Werte nebeneinander.
  • Bestimme daraus 3-5 zentrale Aussagen, auf die sich mein Text am stärksten stützen soll.
  • Prüfe nur diese 3-5 Aussagen anhand der Originalpublikation, PubMed oder der Journal-Website: Stimmen Population, Effektmaß und Konfidenzintervall mit der Tool-Zusammenfassung überein? Gibt es eine Korrektur, ein Erratum oder eine Retraktion? Führe dabei keine neue Literaturrecherche durch, sondern verifiziere nur, was bereits genannt wurde.
  • Wenn du eine Quelle nicht einsehen kannst, kennzeichne sie ausdrücklich als „nicht verifiziert". Behaupte niemals, etwas geprüft zu haben, wenn du es nicht tatsächlich aufgerufen hast.
  • Gib mir am Ende eine kurze Liste: welche der 3–5 Kernaussagen sind bestätigt, welche weichen vom Original ab, welche bleiben ungeprüft.“

2. Eine bereinigte Ausgangsbasis erstellen

  • Aus dem Vergleich entsteht eine geprüfte Übersicht, z. B. eine Evidenztabelle
  • nur was in dieser „bereinigten“ Basis steht, sollte im nächsten Schritt in einen Textentwurf einfließen
  • Enthält auch: was bestätigt ist, was nur teilweise geprüft und was trotz Korrektur/Erratum nicht mehr verwendet werden sollt
  • diese Basis ist der einzige Input für die folgenden Schreib-Prompts, nicht die „Rohantworten“ der Tools.

3. Abschnittsweise schreiben Vorlage: Hintergrund / Einleitung

  • Fasse aus der folgenden geprüften Evidenzübersicht [Übersicht einfügen] den aktuellen Forschungsstand zu [Fragestellung] zusammen.
  • Struktur:
  • 1) zentrale Definitionen/Abgrenzungen,
  • 2) Hauptbefunde mit Kennzahlen
  • 3) Punkte, in denen sich die Quellen uneinig sind
  • 4) offene Fragen.
  • Nur Aussagen verwenden, die in der Übersicht mit Quelle belegt sind.
  • Keine eigene Bewertung, keine über die Quellen hinausgehenden Schlussfolgerungen.

3. Abschnittsweise schreiben Vorlage: Diskussion (mit eigenen Daten)

  • Hier sind meine eigenen Ergebnisse: [eigene Daten/Befunde]
  • Hier ist der aktuelle Forschungsstand: [z.B. KI-generierte Evidenzübersicht]
  • Formuliere einen Rohentwurf, der meine Ergebnisse in diesen Forschungsstand einordnet.
  • Zeige auf, inwiefern meine Ergebnisse die Literatur bestätigen, ergänzen oder ihr widersprechen.
  • Vermeide Scheinkausalitäten und Interpretationen, die über meine Daten hinausgehen.
  • Wichtig bei diesem Schritt:
  • KI neigt zu Scheinkonsens, Übergeneralisierung und Sykophanzie
  • Deshalb KI explizit anweisen, Differenzen, Bias und Limitationen klar herauszuarbeiten

(Methoden- und Ergebnissteil)

  • Für diese Abschnitte gilt: KI darf nur sprachlich glätten
  • KI darf keine Inhalte erzeugen oder umformulieren, die Zahlen, Methodik oder Kausalaussagen verändern
  • Ein Prompt lautet hier höchstens: „Formuliere diesen Absatz klarer, ohne Inhalt, Zahlen oder Aussagen zu verändern“
  • Ein Prompt lautet nicht: „Schreib den Ergebnisteil aus diesen Daten“
  • Wenn Sie KI die Rohdaten geben und sagen „Schreib den Ergebnisteil“, neigt die KI dazu, Nachkommastellen zu runden oder aus einem p-Wert von 0,051 ein signifikantes Ergebnis zu machen („zeigte eine deutliche Tendenz und somit einen klaren Zusammenhang“)
  • Für ein LLM ist der Unterschied zwischen 0,049 und 0,051 sprachlich winzig, medizinisch entscheidet er aber über Signifikanz oder Nicht-Signifikanz
  • Im Methoden- und Ergebnisteil ist die KI nur Korrektor / Lektor, aber nicht Autor

4. KI-Entwurf prüfen, eigene Stimme und Substanz behalten

  • KI-Entwürfe laden dazu ein, nur noch zu lesen statt zu denken
  • Wer KI alles schreiben lässt und das Ergebnis nur noch nach Fehlern absucht, lagert genau den Denkprozess an KI aus, der beim Schreiben stattfinden soll
  • Problem existiert auch bei Patientenbefragungen und klinischen Notizen mit KI (Link)
  • KI schreibt und strukturiert Texte so gut, dass sie nur selten nachgeprüft werden (sog. Processing fluency)
  • Wer nur liest, was die KI geschrieben hat, sucht nur noch Fehler in einem Text, der so souverän klingt, dass es verlockend ist, ihn einfach zu übernehmen
  • Deshalb: selbst formulieren bzw. jeden KI-Entwurf komplett durcharbeiten und umschreiben, nicht nur redigieren.
  • Konkret bleiben: Wo der KI-Text vage oder allgemein wird, selbst nachschärfen.

5. Transparenz nicht vergessen

  • Viele Journals verlangen eine Offenlegung, ob, wie und bei welchen Arbeitsschritten KI bei der Erstellung eines Papers eingesetzt wurde
  • vorab in den KI-Richtlinien der Zielpublikation prüfen
  • konkrete Formulierung / Platzierung der Disclosure und Erlaubnisumfang unterscheiden sich je Journal
  • Deshalb: vor jeder Einreichung die "Author Guidelines" prüfen, nicht nur einmal pauschal
  • KI kann nach aktuellen Standards (ICMJE, COPE) nicht als Autor gelten
  • Verantwortung für den Inhalt bleibt bei den Autoren
  • die Nichtoffenlegung von KI-Nutzung gilt zunehmend als Forschungsfehlverhalten (research misconduct), nicht mehr nur als Verstoß gegen redaktionelle Richtlinien

Quiz

27 Fragen zum Thema. Bei falschen Antworten führt ein Link zur passenden Stelle. Ihr Ergebnis wird nicht gespeichert.

Tools und Links

Alle in den Inhalten genannten Links, sortiert. Die Angabe verweist auf das Kapitel.

Recherche-Tools und Suchmaschinen

Studien, Quellen und weitere Links

Beispielergebnisse

Nicht sicher, was passt?

Beschreiben Sie einfach kurz Ihre Situation. Ich schaue mir das in Ruhe an, und in einem Beratungsgespräch klären wir gemeinsam, welches Format passt. Natürlich komplett kostenfrei und unverbindlich.

Ein Workshop zu diesem Thema für Ihre Einrichtung?

Ich passe Inhalt, Beispiele und Tiefe an Fach und Vorwissen an.