Wie kommen Paywall-Studien in KI-Tools? Human Mining
Wie kommen Inhalte aus Studien, die hinter Paywalls liegen, in KI-Tools?
Die Frage stellt ein Praxis-Paper von Daniel W. Hook, das kürzlich auf arXiv publiziert wurde.
Hooks grundlegende Erkenntnis: Forscher lesen eine Paywalled-Studie, zitieren sie später in einem Open-Access-Paper und geben dabei Teile des Befunds weiter. Die Studie zählt offene Zitationen, ohne systematisch zu prüfen, ob sie den Inhalt des zitierten Artikels angemessen und korrekt wiedergeben. (Nebenbei bemerkt: Hook zeigt verschiedene Fehler, z.B. werden Ergebnisse einem anderen Paper zugerechnet, Zitationen sind unpassend, Befunde werden verwechselt oder übertrieben usw.) Hook bezeichnet die berechnete Sichtbarkeit deshalb auch als optimistische Obergrenze.
Aber das nur am Rande. Wichtig ist: Ein KI-System, das offene Artikel liest, kann dadurch etwas über Artikel erfahren, die hinter einer Paywall liegen oder nur durch eine Subskription zugänglich sind.
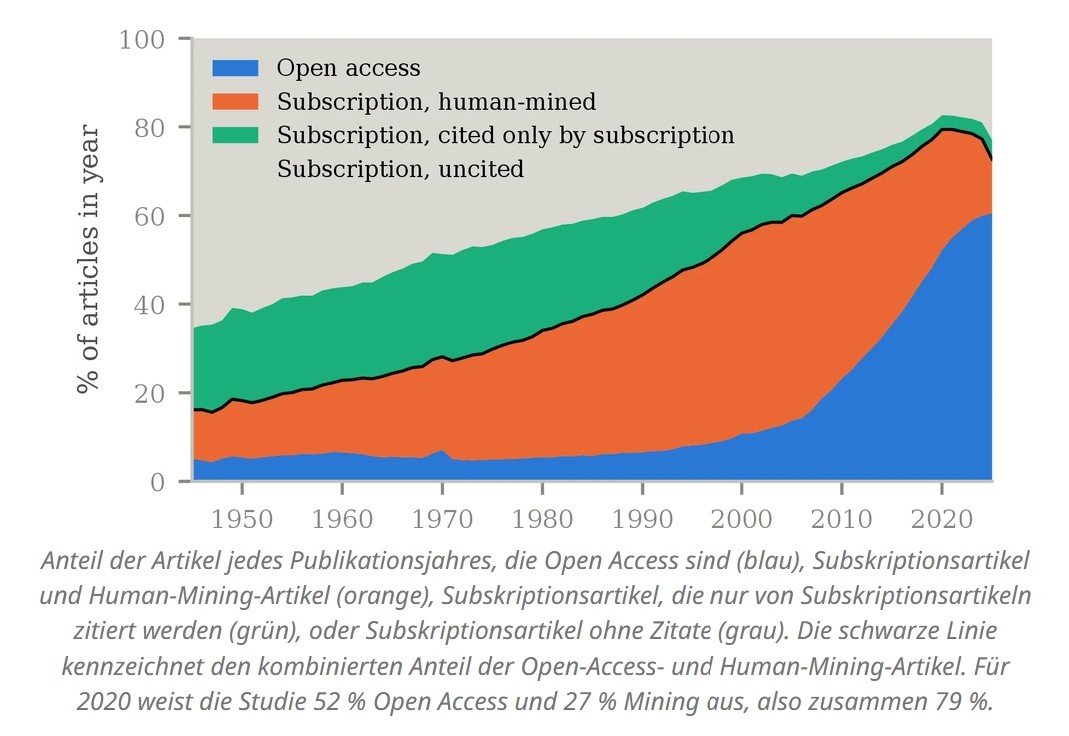
Hook nennt das human mining. Die Forscher wirken also als Vermittler von Inhalten in offene Systeme. Und das machen sie immer schneller. Die Studie hat gemessen, wie lange ein Subskriptionsartikel braucht, bis er erstmals in einem Open-Access-Artikel zitiert wird. Der Median lag bei 13 Jahren bei Artikeln aus dem Jahr 1990, bei Artikeln aus dem Jahr 2020 war es nur noch 1 Jahr.
Rechnet man die offenen Artikel und die durch Zitationen offen gemachten Artikel zusammen, ergibt sich, dass im Jahr 2020 rund 79% aller Artikel offenlagen. Tendenz seit den 1990er Jahren steigend. Heißt auch: Ältere Forschung war lange nur über geschlossene Zitationswege sichtbar, während neuere Arbeiten viel schneller Spuren in offenen Korpora hinterlassen.
Was lässt sich daraus für KI-Recherche-Tools und ihre Nutzer ableiten? (Meine Deutung)
Zunächst mal: Ein Artikel kann in einer Trefferliste erscheinen, ohne dass das Tool den Volltext gelesen hat. Eine KI-Antwort kann auf einer Mischung aus Metadaten, Abstracts, offenen Volltexten und indirekten Zusammenfassungen beruhen.
Heißt auch: Ein KI-System kann den Titel und das Abstract kennen, aber nicht die Methoden, Tabellen, Abbildungen oder Einschränkungen aus dem Volltext.
Zudem kann es passieren, dass ein KI-System statt des Originals eine Zusammenfassung übernimmt, die den ursprünglichen Befund verkürzt hat.
Praktisch heißt das: KI-Recherche-Tools sind super, um Literatur aufzuspüren und Themen zu ordnen. Für inhaltliche Feinheiten, spezielle Kontexte, Methoden und die Limitationen der Ergebnisse bleibt der Originalartikel – wenn zugänglich – aber die entscheidende Prüfquelle.
Das bedeutet: Bei einer wichtigen Aussage sollte man nachsehen, worauf die Antwort tatsächlich gestützt ist: auf den Volltext des Primärartikels, auf dessen Abstract oder auf eine andere Arbeit, die ihn zitiert. In den meisten Tools ist das sichtbar.
Abb. aus Hooks Paper, Beschriftung auf Deutsch via alphaXiv (Link zum Paper)