Ein paar lockere Gedanken über fixe Recherche-Pipelines. Und ein paar fixe Gedanken über lockere Recherche-Pipelines.
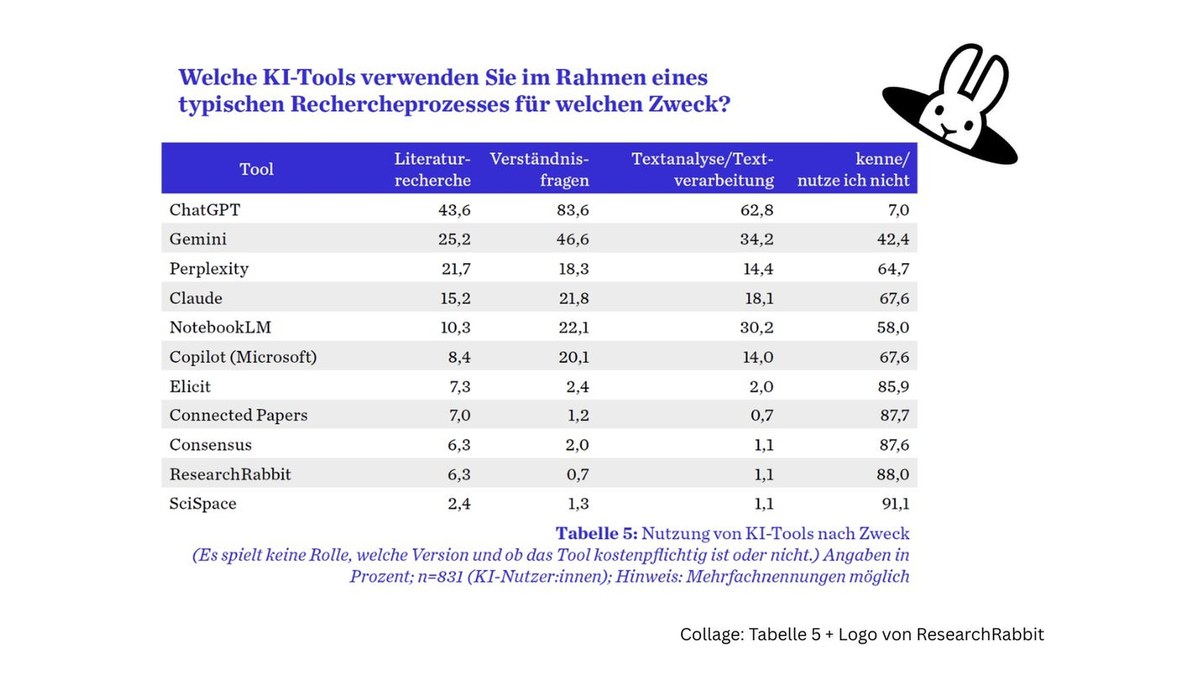
Ich schreibe hier oft über Recherche-KI-Tools: SciSpace, Elicit, Consensus... es gibt über 50 und immer mehr verpartnern sich mit ChatGPT und Claude. Der Funktionsumfang ist dort zwar geringer, aber die Zahl der (potentiellen) Nutzer viel höher.
Tool, Skill und Konnektor als Team
Um die Ergebnisse zu verbessern, empfiehlt es sich, aber noch spezielle Recherche-Skills mit in den Workflow zu nehmen. (Es gibt auf GitHub und Co unzählige davon.) Die Suche läuft also so: man nimmt eine Allzweck-KI (z.B. Claude), klemmt ein Recherchetool (z.B. Consensus) als Konnektor dran und schaltet einen Literature-Review-Skill davor.
Für alle, die Skills nicht kennen: das ist die Arbeitsanweisung, die der KI sagt, wie eine Suche abläuft. Im Grunde ein Recherche-Rezept: "Durchsuche mindestens fünf Datenbanken, dedupliziere, bewerte jede Studie nach diesen Kriterien, wähle themenstratifiziert aus."
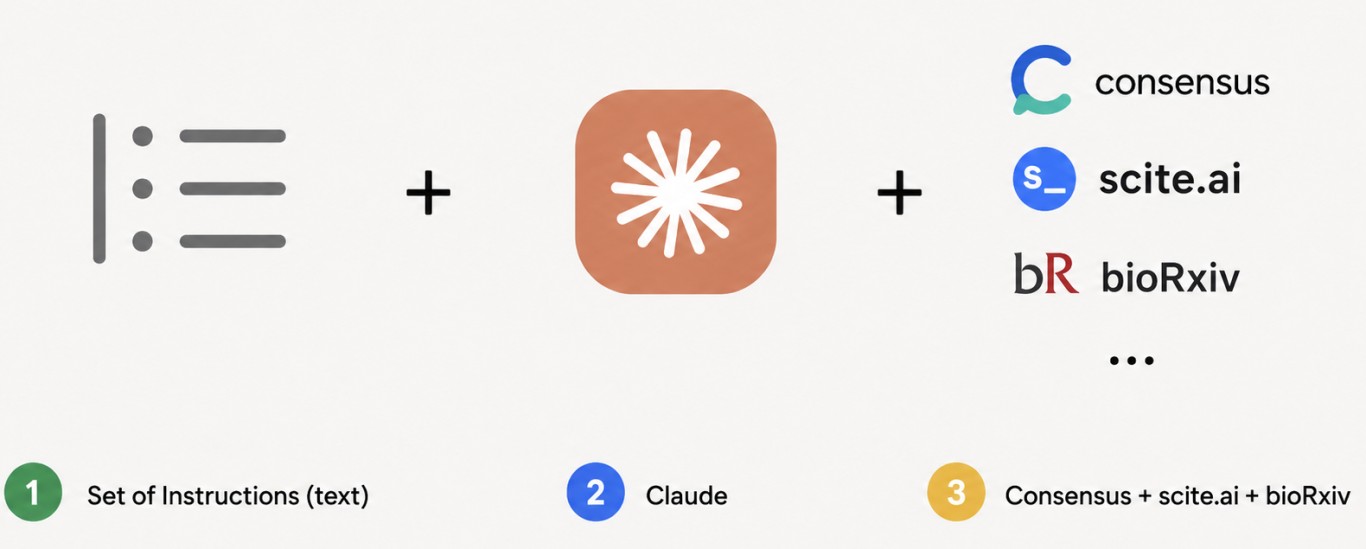
Die Idee dahinter: Das Tool durchsucht einen Korpus. Der Stack kann (wenn Zugriff, Einstellungen und Datenbankanbindung stimmen) mehrere Datenbanken recherchieren, Treffer deduplizieren, nach klaren Kriterien screenen, Ausschlussgründe notieren, die Qualität der Quellen bewerten und am Ende die DOIs prüfen.
Im Grunde sind das drei Jobs, nur eben sauber getrennt: Der Konnektor findet, der Skill gibt die Methode vor, und die KI führt aus, extrahiert, vergleicht und synthetisiert.
Wo die Pipeline noch hakt
Oft sind die Ergebnisse meiner Erfahrung nach aber (noch) nicht gut. Das liegt meist daran, dass die Skills zu unspezifisch sind, einige Datenbanken die Anfragen drosseln oder nicht zulassen oder in den Claude-Einstellungen bei der Auswahl, auf welche Domains zugegriffen werden kann, "nur Paketmanager" eingestellt ist. Dann kann man alles freigeben oder die relevanten Datenbanken hinzufügen.
Dafür muss man aber wissen, welche es gibt und worauf ich Zugriff habe, welche für mein Thema und welche generell relevant sind: OpenAlex? Base? Livivo? PubMed? Scopus? Web of Science? Datenbank-Kenntnisse sind also auch im KI-Zeitalter nötig. Nur dann öffnet sich die Recherche-Pipeline und wird von einem dünnen Gartenschlauch zu einem 80er Rohr mit ordentlich Durchfluss.
Wobei mehr Durchfluss auch mehr Dubletten, mehr irrelevante Treffer, mehr falsch-positive Studien und mehr Screening-Aufwand bedeuten. Und noch ein Problem bleibt: die Auswahl, Bewertung und Analyse der Quellen. Da selektiert die KI oft (noch) nicht gut genug, ist manchmal zu streng, manchmal zu großzügig, oder (er-)kennt die Lücken im Korpus nicht und richtet die Suche dadurch generell falsch aus. Hier ist und bleibt die Expertise des Menschen entscheidend.
Kurzum: Auch Recherche-Pipelines sind nur so stark wie ihr schwächstes Glied. Das kann der Konnektor sein, der relevante Quellen nicht erreicht. Es kann der Skill sein, der die Suchmethode zu vage vorgibt. Es kann die KI sein, die Treffer schlecht bewertet. Und es kann der Mensch sein, der zu sehr auf die KI vertraut.
Bild: Abbildung einer Recherche-Pipeline aus Skill + Claude + Auswahl verschiedener Recherche-Tools