Statistik für Menschen, die Statistik eigentlich meiden (Teil 1 von 4) oder: Ein bekanntes Problem, ein halbwegs bekanntes KI-Tool und eine unbekannte Studie
Ein Sprichwort, das gemeinhin Karl Valentin zugeschrieben wird, tatsächlich aber aus der Filmoper „Die verkaufte Braut“ stammt, besagt: „Kunst ist schön, macht aber viel Arbeit.“
Das gleiche gilt für Statistik. Das heißt: galt, denn inzwischen gibt es jede Menge KI-Tools, die einem die Arbeit abnehmen. Sie führen komplexe statistische Berechnungen durch, erklären die Ergebnisse in aller Breite und Tiefe und visualisieren sie in jeder erdenklichen Form.
Das ist nicht nur schön anzusehen, sondern hat auch was von der vielbeschworenen „Demokratisierung durch KI“, schließlich haben viele Menschen keine Statistikausbildung. Selbst grundlegende Kenntnisse sind Mangelware. Auch unter Akademikern. Die meisten Menschen begegnen statistischen Berechnungen wie der Bedienungsanleitung eines neuen Druckers: man ahnt, dass man sie besser lesen sollte, überfliegt ein, zwei Absätze – und wirft die Anleitung aus Frust in die Ecke, in der Hoffnung, dass es auch ohne geht.
Für gewöhnlich geht’s dann nur schief – und genau hier kommen die KI-Tools ins Spiel, denn die versprechen, dass jetzt nichts mehr schief gehen kann. Riesige Zahlenreihen, Excel-Tabellen – alles kann mit natürlicher Sprache analysiert und ausgewertet werden. Und das wird (zumindest von einigen) auch getan. KI-Tools senken die Hemmschwelle: Statistik wirkt weniger bedrohlich. Man kann „Statistik probieren“ ohne zu scheitern - und wirft Excel-, SPSS-, Python und andere (Hand)Bücher mit sieben Siegeln getrost in die Ecke.
Das Schöne ist: durch dieses natürliche, dialogorientierte und fehlertolerante Arbeiten wird Statistik lernbar, denn die Tools erklären, was sie tun und wie die Ergebnisse zu bewerten sind.
Die entscheidende Frage: Taugen die Tools wirklich?
Die entscheidende Frage lautet aber nicht, ob diese Tools bequem sind (das sind sie), sondern ob sie wirklich was taugen?
Im Folgenden gibt es paar Antworten. Und einen kleinen „Transparenzhinweis“ vorweg: Meine eigenen Statistikkenntnisse würde ich als ganz gut beschreiben – für einen studierten Geisteswissenschaftler. Für einen Hardcore-Soziologen sind sie gewiss ausbaufähig.
Meine eigenen Tools im Einsatz
Ich selbst nutze für Statistik, Datenanalysen und Visualisierungen vor allem julius.ai, greife aber auch gern auf Excelmatic (Neu Gls), einen (getunten) Datenanalysen-Agenten von Mistral AI und ein paar andere Tools zurück. Wenn's sensible Daten sind, ist Orange Data Mining eine gute Option.
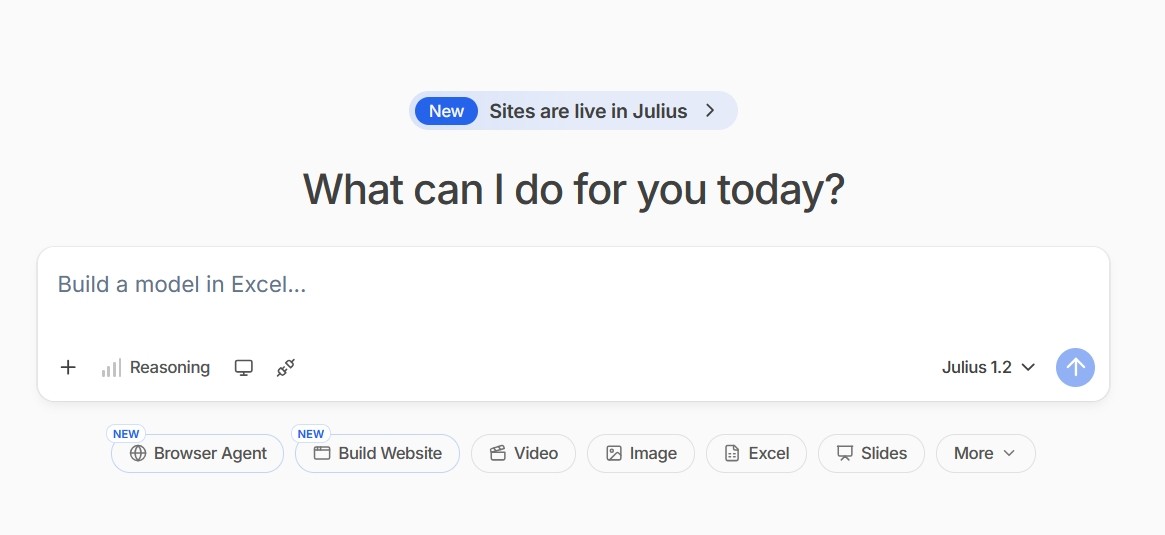
Durch den parallelen Einsatz kann ich Ergebnisse vergleichen und mich dort, wo meine eigenen Kenntnisse an ihre Grenzen kommen, durch den Vergleich absichern, nachfragen, gegenchecken.
Aber was bringen diese Tools nun? Wie sehen die empirischen Erkenntnisse dazu aus? Das steht in Teil 2...